Web scraping là gì? Web scraping (cào dữ liệu web) là kỹ thuật dùng chương trình tự động để truy cập trang web, trích xuất thông tin cần thiết như giá, tiêu đề, mô tả, đánh giá rồi lưu thành dữ liệu có cấu trúc (bảng tính, cơ sở dữ liệu). Việc này thay cho thao tác sao chép thủ công, nhưng chỉ nên làm trong phạm vi pháp luật, điều khoản của website và quyền riêng tư cho phép.
Bài này giải thích web scraping hoạt động ra sao, khác crawling và API thế nào, dùng vào việc gì trong marketing và SEO, cách làm có trách nhiệm từng bước, những giới hạn pháp lý và đạo đức cần cân nhắc, và khi nào bạn nên chọn cách khác. Nội dung mang tính tham khảo, không phải tư vấn pháp lý; nếu dự án thu thập dữ liệu quy mô lớn hoặc có dữ liệu cá nhân, hãy tham khảo luật sư.
Mục lục
- Web scraping là gì?
- Web scraping, web crawling và API khác nhau thế nào?
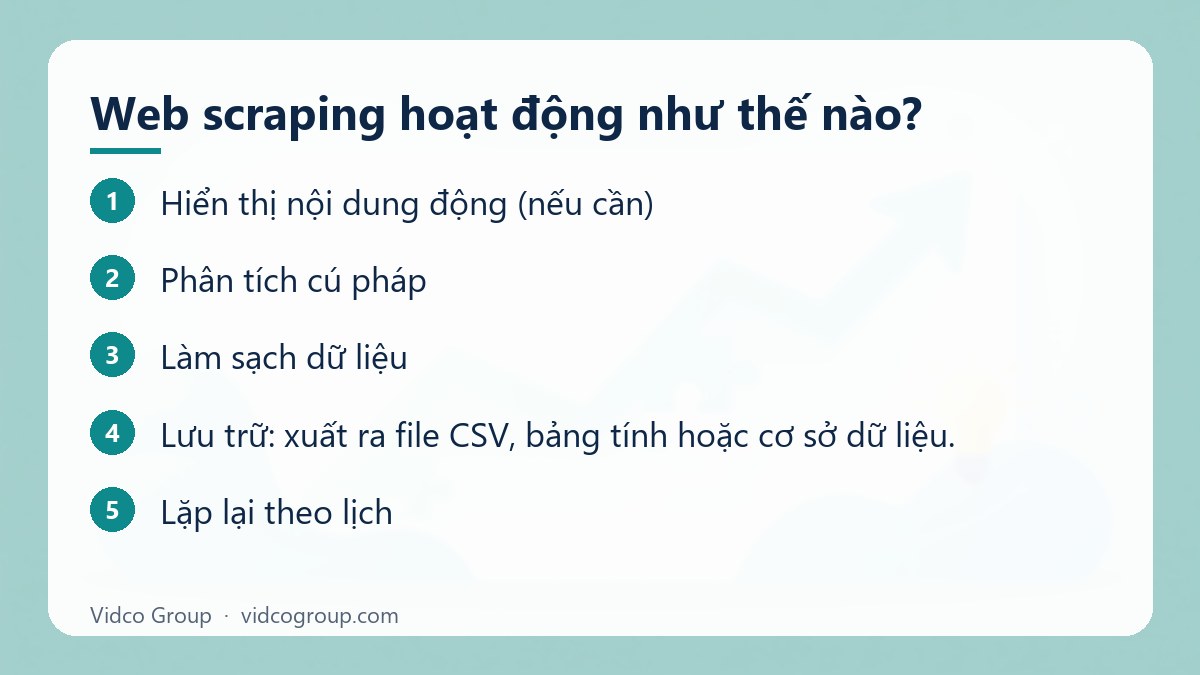
- Web scraping hoạt động như thế nào?
- Ứng dụng trong marketing, SEO và kinh doanh
- Web scraping có hợp pháp không?
- Cách làm web scraping có trách nhiệm
- Chọn công cụ và cách tiếp cận
- Giới hạn và rủi ro kỹ thuật
- Khi nào không nên scraping?
- Lỗi thường gặp
- Câu hỏi thường gặp
- Nguồn tham khảo
Web scraping là gì?
Khi bạn mở một trang sản phẩm, trình duyệt tải mã HTML và hiển thị cho bạn đọc. Web scraping làm bước tương tự bằng chương trình: tải mã trang, tìm các phần tử chứa thông tin (tên sản phẩm, giá, tồn kho, ngày đăng), rồi tách ra thành dòng dữ liệu. Thay vì nhìn từng trang, bạn có bảng dữ liệu để phân tích.
Dữ liệu thu về có thể là văn bản, số, đường dẫn, hình ảnh hoặc bảng. Điểm mấu chốt là dữ liệu đó thường đã được website hiển thị công khai, nhưng “công khai” không đồng nghĩa với “được tự do thu thập và sử dụng cho mọi mục đích”. Đây là lý do phần pháp lý và đạo đức luôn đi kèm khi nói về scraping.
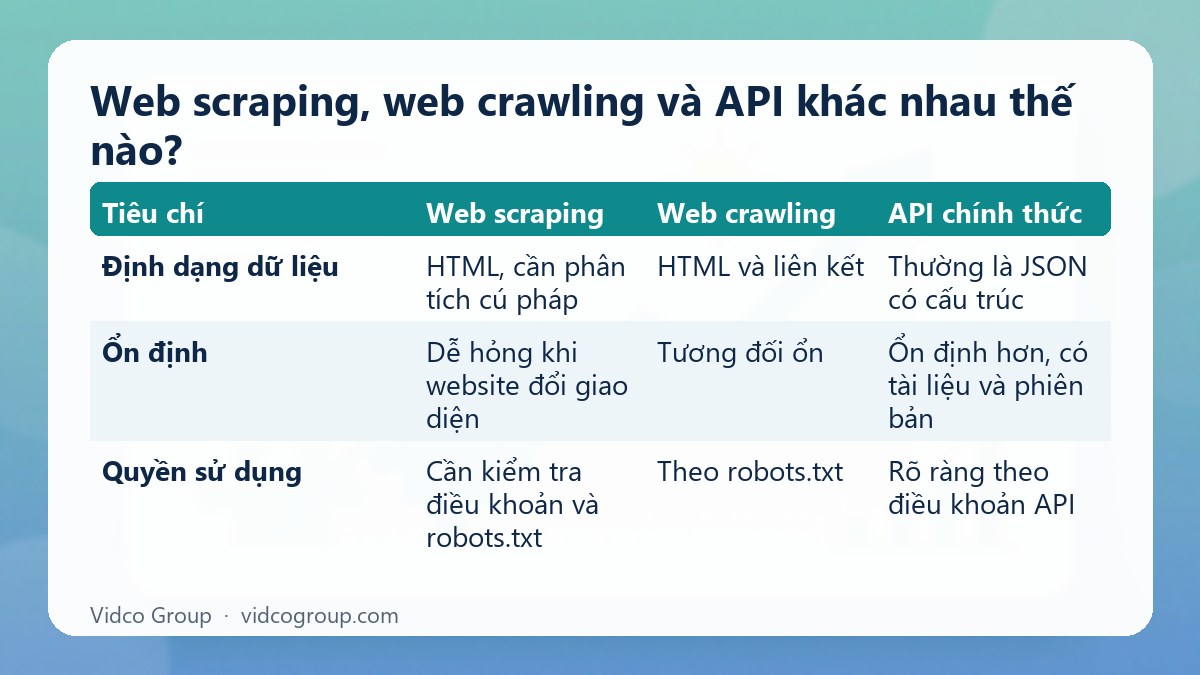
Web scraping, web crawling và API khác nhau thế nào?
| Tiêu chí | Web scraping | Web crawling | API chính thức |
|---|---|---|---|
| Mục tiêu | Trích xuất dữ liệu cụ thể từ trang | Khám phá và duyệt nhiều trang qua liên kết (ví dụ để lập chỉ mục) | Lấy dữ liệu qua giao diện do chủ sở hữu cung cấp |
| Ví dụ | Lấy giá và tên sản phẩm của một danh mục | Googlebot duyệt web để lập chỉ mục | Gọi API để lấy dữ liệu đơn hàng, thời tiết, thanh toán |
| Định dạng dữ liệu | HTML, cần phân tích cú pháp | HTML và liên kết | Thường là JSON có cấu trúc |
| Ổn định | Dễ hỏng khi website đổi giao diện | Tương đối ổn | Ổn định hơn, có tài liệu và phiên bản |
| Quyền sử dụng | Cần kiểm tra điều khoản và robots.txt | Theo robots.txt | Rõ ràng theo điều khoản API |
Hai khái niệm đầu hay đi cùng nhau: một công cụ thu thập dữ liệu thường vừa crawl (đi qua nhiều trang) vừa scrape (lấy thông tin từ mỗi trang). Nếu bạn muốn hiểu phần duyệt trang của công cụ tìm kiếm, xem web crawler là gì. Khi nhà cung cấp dữ liệu có API, hãy ưu tiên API vì ổn định và rõ ràng về quyền sử dụng.
Web scraping hoạt động như thế nào?
- Gửi yêu cầu: chương trình gửi yêu cầu HTTP đến địa chỉ trang, giống trình duyệt, và nhận lại mã HTML.
- Hiển thị nội dung động (nếu cần): một số trang tải dữ liệu bằng JavaScript sau khi mở. Khi đó cần trình duyệt không giao diện (headless browser) để chạy mã rồi mới đọc kết quả.
- Phân tích cú pháp: chương trình đọc cấu trúc HTML và chọn đúng phần tử bằng bộ chọn CSS, XPath hoặc biểu thức.
- Làm sạch dữ liệu: bỏ khoảng trắng, chuẩn hóa đơn vị tiền, ngày tháng, loại bỏ trùng lặp.
- Lưu trữ: xuất ra file CSV, bảng tính hoặc cơ sở dữ liệu.
- Lặp lại theo lịch: chạy định kỳ để theo dõi thay đổi theo thời gian, với tần suất vừa phải.
Một ví dụ cực ngắn bằng Python, minh họa ý tưởng: kiểm tra robots.txt trước, rồi lấy tiêu đề một trang (đã được chủ website cho phép):
import time
import requests
from urllib import robotparser
from bs4 import BeautifulSoup

url = "https://example.com/trang-can-lay"
agent = "TenBotCuaToi/1.0 (lienhe@example.com)"

rp = robotparser.RobotFileParser("https://example.com/robots.txt")
rp.read()

if rp.can_fetch(agent, url):
    r = requests.get(url, headers={"User-Agent": agent}, timeout=20)
    r.raise_for_status()
    soup = BeautifulSoup(r.text, "html.parser")
    print(soup.title.get_text(strip=True))
    time.sleep(5)  # nghỉ giữa các yêu cầu để không gây tải
else:
    print("Không được phép lấy trang này theo robots.txt")
Đoạn mã chỉ để hiểu nguyên lý. Dự án thật cần xử lý lỗi, giới hạn tần suất, ghi nhật ký và kiểm tra điều khoản của từng website. Tài liệu chính thức của thư viện phân tích HTML Beautiful Soup và khung thu thập dữ liệu Scrapy là điểm bắt đầu tốt.
Ứng dụng trong marketing, SEO và kinh doanh
| Mục đích | Dữ liệu thường thu | Lưu ý hợp lệ |
|---|---|---|
| Theo dõi giá, tồn kho đối thủ | Giá niêm yết, tình trạng còn hàng | Chỉ dùng thông tin công khai; xem điều khoản website; dùng để định giá nội bộ, không để sao chép nội dung |
| Nghiên cứu thị trường | Danh mục sản phẩm, mô tả, xu hướng | Tổng hợp, phân tích; không đăng lại nguyên văn |
| Kiểm tra SEO website của chính bạn | Thẻ tiêu đề, mô tả, H1, liên kết hỏng, canonical | Rất phổ biến và an toàn khi làm trên site của mình |
| Phân tích nội dung đối thủ ở mức cấu trúc | Chủ đề, số mục, độ dài, thẻ heading | Học cấu trúc, không sao chép; viết nội dung gốc |
| Thu thập dữ liệu để huấn luyện mô hình | Văn bản, hình ảnh | Nhiều rủi ro về bản quyền và điều khoản; cần tư vấn pháp lý |
| Tổng hợp tin tức, danh sách việc làm, bất động sản | Tiêu đề, link, tóm tắt | Dẫn nguồn, tuân thủ bản quyền, ưu tiên nguồn cấp (RSS/API) |
| Theo dõi thương hiệu trên web | Bài đăng công khai nhắc đến thương hiệu | Tránh thu thập dữ liệu cá nhân không cần thiết |
Trong SEO, scraping hợp lý nhất là để kiểm tra website của chính bạn hoặc website bạn có quyền (ví dụ kiểm tra hàng loạt thẻ tiêu đề). Nhiều công cụ SEO thương mại thực chất cũng thu thập dữ liệu ở quy mô lớn và bán lại dưới dạng báo cáo, ví dụ SimilarWeb hay các công cụ trong danh sách công cụ SEO; dùng sản phẩm có sẵn thường tiết kiệm và ít rủi ro hơn tự xây hệ thống.
Web scraping có hợp pháp không?
Không có câu trả lời “có” hoặc “không” chung cho mọi trường hợp. Tính hợp pháp phụ thuộc vào loại dữ liệu, cách thu thập, mục đích sử dụng và quốc gia áp dụng. Một số điểm cần cân nhắc ở Việt Nam và quốc tế:
- Dữ liệu cá nhân: tên, số điện thoại, email, hình ảnh nhận dạng của cá nhân chịu sự điều chỉnh của luật bảo vệ dữ liệu cá nhân. Việt Nam có Luật Bảo vệ dữ liệu cá nhân hiệu lực từ 01/01/2026 (số 91/2025/QH15), cùng các văn bản hướng dẫn. Việc thu thập, mua bán hay sử dụng dữ liệu cá nhân thường cần cơ sở pháp lý và sự đồng ý phù hợp. Hãy kiểm tra quy định hiện hành.
- Bản quyền: nội dung bài viết, hình ảnh, cơ sở dữ liệu có thể được bảo hộ. Sao chép và đăng lại có thể vi phạm bản quyền dù bạn lấy được bằng công cụ.
- Điều khoản sử dụng của website: nhiều trang cấm thu thập tự động. Vi phạm điều khoản có thể dẫn đến bị chặn hoặc tranh chấp dân sự.
- Truy cập trái phép và vượt rào cản bảo vệ: vượt qua đăng nhập, mã xác thực, hệ thống chống bot hoặc lấy dữ liệu sau khu vực yêu cầu tài khoản có thể bị xem là truy cập trái phép. Không nên thực hiện.
- Gây quá tải máy chủ: gửi yêu cầu dồn dập làm ảnh hưởng hoạt động của website có thể gây rủi ro pháp lý và gây hại cho chủ trang.
- Quốc gia khác nhau: nếu dữ liệu thuộc website hoặc người dùng nước ngoài, quy định khác có thể áp dụng.
Hãy xem đây như danh sách câu hỏi cần trả lời trước khi bắt đầu, không phải kết luận pháp lý. Với dự án thương mại hoặc dữ liệu nhạy cảm, nên tham khảo luật sư.
Cách làm web scraping có trách nhiệm
- Xác định rõ mục đích và dữ liệu tối thiểu cần thiết. Chỉ thu thập những gì phục vụ mục đích; tránh dữ liệu cá nhân nếu không thật cần.
- Tìm nguồn chính thức trước. Có API, file dữ liệu mở, nguồn cấp RSS hay đối tác cung cấp dữ liệu không? Nếu có, dùng nguồn này.
- Đọc điều khoản sử dụng và chính sách của website. Nếu cấm thu thập tự động, hãy xin phép chủ website hoặc tìm nguồn khác.
- Kiểm tra robots.txt. Đây là file chỉ dẫn cho trình thu thập dữ liệu, được chuẩn hóa trong RFC 9309 và mô tả trong tài liệu của Google. Lưu ý robots.txt là quy ước chỉ dẫn, không thay thế điều khoản sử dụng và không phải cơ chế bảo mật. Xem thêm robots.txt là gì.
- Nhận diện rõ chương trình của bạn. Đặt User-Agent có tên và thông tin liên hệ để chủ website liên hệ nếu cần.
- Giới hạn tần suất. Nghỉ giữa các yêu cầu, chạy vào khung giờ ít tải, dừng khi gặp mã lỗi 429 (quá nhiều yêu cầu), theo mô tả của MDN về mã 429.
- Lưu đệm kết quả. Không tải lại trang không thay đổi; giảm số yêu cầu gửi đến máy chủ.
- Làm sạch và kiểm tra chất lượng. Đối chiếu mẫu với trang thật, xử lý ô trống, đơn vị và định dạng.
- Bảo vệ dữ liệu đã thu. Phân quyền truy cập, mã hóa khi cần, đặt thời hạn lưu và xóa khi không còn dùng.
- Ghi nhận nguồn và tôn trọng bản quyền. Khi dùng kết quả công khai, dẫn nguồn, không sao chép nguyên văn nội dung có bản quyền.
- Giám sát và bảo trì. Website đổi cấu trúc sẽ làm bộ thu thập hỏng; cần cảnh báo khi dữ liệu bất thường.
Chọn công cụ và cách tiếp cận
| Cách tiếp cận | Phù hợp | Ưu điểm | Hạn chế |
|---|---|---|---|
| Dùng API hoặc dữ liệu mở | Mọi dự án có nguồn chính thức | Ổn định, rõ quyền sử dụng | Có thể giới hạn dữ liệu hoặc tính phí |
| Công cụ không cần code (tiện ích trình duyệt, ứng dụng kéo thả) | Việc nhỏ, lấy bảng dữ liệu đơn giản | Nhanh, không cần lập trình | Khó mở rộng, hạn chế với trang động |
| Thư viện lập trình (Python, JavaScript) | Dự án tùy chỉnh, cần kiểm soát | Linh hoạt, chi phí thấp | Cần kỹ năng, phải bảo trì |
| Khung thu thập quy mô lớn (như Scrapy) | Dự án nhiều trang, chạy định kỳ | Quản lý hàng đợi, tốc độ, lưu trữ | Đường học dốc hơn |
| Trình duyệt tự động (headless) | Trang tải dữ liệu bằng JavaScript | Đọc được nội dung động | Chậm, tốn tài nguyên |
| Mua dữ liệu hoặc thuê đơn vị cung cấp hợp pháp | Doanh nghiệp không có đội kỹ thuật | Giảm gánh nặng kỹ thuật và pháp lý | Chi phí, cần kiểm tra nguồn gốc dữ liệu |
Chúng tôi không khuyến nghị một công cụ cụ thể, vì lựa chọn tùy mục tiêu và năng lực kỹ thuật. Tiêu chí chung: có tài liệu rõ, cộng đồng hoạt động, hỗ trợ giới hạn tần suất và ghi nhật ký.
Giới hạn và rủi ro kỹ thuật
- Dễ hỏng khi website đổi giao diện: chỉ cần đổi tên lớp CSS là bộ lấy dữ liệu trả về rỗng.
- Dữ liệu không đồng nhất: đơn vị, định dạng, ngôn ngữ khác nhau giữa các nguồn.
- Nội dung tải bằng JavaScript: cần công cụ chạy trình duyệt, tốn tài nguyên hơn.
- Hệ thống chống truy cập tự động: nhiều website giới hạn tần suất hoặc chặn bot. Đây là tín hiệu rằng chủ trang không muốn bị thu thập tự động; hãy dừng và tìm nguồn chính thức thay vì cố vượt qua.
- Dữ liệu cũ nhanh: giá và tồn kho thay đổi liên tục, cần lịch chạy hợp lý.
- Chi phí vận hành: lưu trữ, máy chủ, công sức bảo trì thường lớn hơn dự kiến ban đầu.
- Dữ liệu sai dẫn đến quyết định sai: luôn có bước kiểm tra mẫu thủ công.
Khi nào không nên scraping?
| Tình huống | Khuyến nghị |
|---|---|
| Website cung cấp API hoặc dữ liệu tải về | Dùng API/dữ liệu chính thức |
| Điều khoản cấm thu thập tự động | Xin phép hoặc tìm nguồn khác |
| Dữ liệu là thông tin cá nhân để chạy tin nhắn, cuộc gọi, quảng cáo | Không làm; cần cơ sở pháp lý và sự đồng ý theo quy định |
| Dữ liệu nằm sau đăng nhập hoặc có rào cản chống bot | Không vượt rào cản; dùng kênh chính thức |
| Mục đích là sao chép toàn bộ nội dung để đăng lại | Không làm; vi phạm bản quyền và ảnh hưởng SEO |
| Chỉ cần vài chục điểm dữ liệu | Thu thập thủ công hoặc dùng công cụ phân tích có sẵn |
| Không có người bảo trì lâu dài | Cân nhắc mua báo cáo hoặc dịch vụ |
Lỗi thường gặp
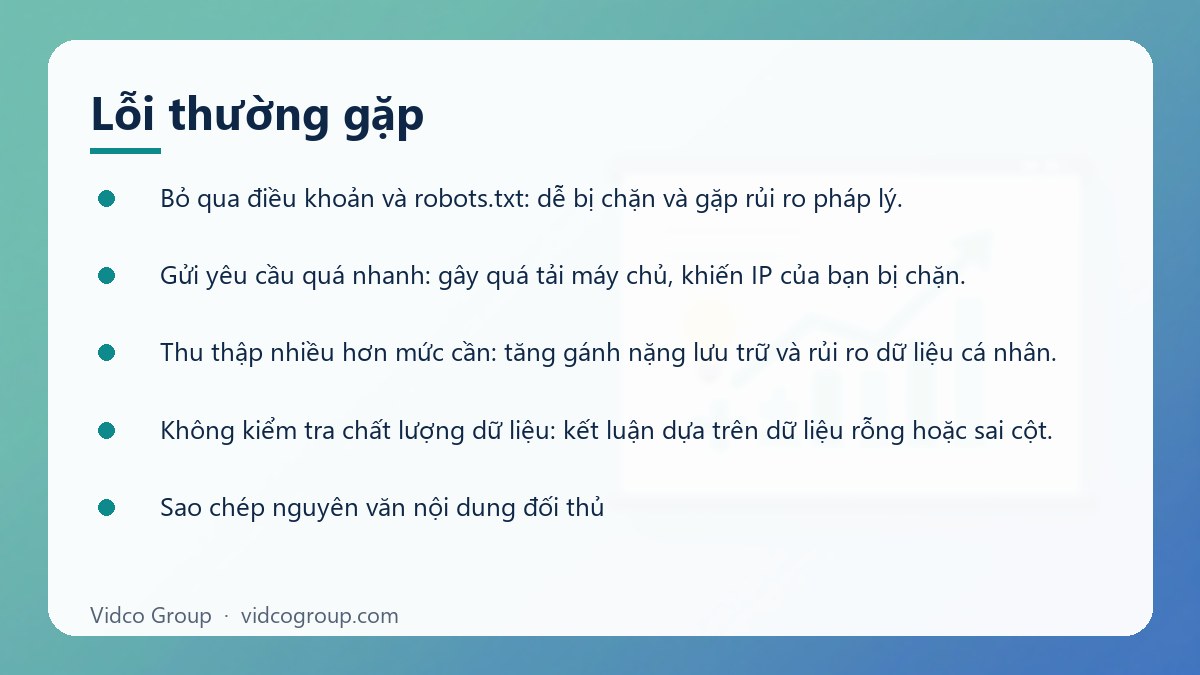
- Bỏ qua điều khoản và robots.txt: dễ bị chặn và gặp rủi ro pháp lý.
- Gửi yêu cầu quá nhanh: gây quá tải máy chủ, khiến IP của bạn bị chặn.
- Thu thập nhiều hơn mức cần: tăng gánh nặng lưu trữ và rủi ro dữ liệu cá nhân.
- Không kiểm tra chất lượng dữ liệu: kết luận dựa trên dữ liệu rỗng hoặc sai cột.
- Sao chép nguyên văn nội dung đối thủ: vi phạm bản quyền và bị công cụ tìm kiếm đánh giá thấp.
- Dùng dữ liệu cá nhân thu được để quảng cáo hoặc nhắn tin hàng loạt: rủi ro pháp lý rõ rệt.
- Không có kế hoạch bảo trì: bộ thu thập hỏng âm thầm.
- Tự xây khi đã có công cụ phù hợp: tốn công không cần thiết.
Câu hỏi thường gặp
Web scraping là gì, hiểu đơn giản?
Là dùng chương trình tự động để lấy thông tin từ các trang web và lưu thành dữ liệu có cấu trúc như bảng tính, thay cho việc sao chép tay.
Web scraping khác web crawling thế nào?
Crawling là đi qua nhiều trang theo liên kết để khám phá nội dung, như cách công cụ tìm kiếm làm. Scraping là trích xuất dữ liệu cụ thể từ trang. Trong thực tế hai việc thường kết hợp.
Web scraping có hợp pháp không?
Phụ thuộc vào loại dữ liệu, cách thu thập, mục đích và quốc gia. Rủi ro cao hơn khi lấy dữ liệu cá nhân, nội dung có bản quyền, vi phạm điều khoản hoặc vượt rào cản truy cập. Hãy kiểm tra quy định hiện hành và tham khảo luật sư với dự án thương mại.
Làm sao biết một trang có cho phép thu thập dữ liệu?
Kiểm tra file robots.txt ở thư mục gốc (ví dụ tenmien.com/robots.txt), đọc điều khoản sử dụng và xem website có API chính thức không. Robots.txt là chỉ dẫn chứ không thay thế điều khoản và quy định pháp luật.
Web scraping dùng để làm gì trong SEO?
Phổ biến nhất là kiểm tra hàng loạt website của chính bạn: thẻ tiêu đề, mô tả, heading, liên kết hỏng, trạng thái trang. Ngoài ra là tổng hợp cấu trúc nội dung để nghiên cứu, nhưng nên viết nội dung gốc thay vì sao chép.
Cần biết lập trình để scraping không?
Không bắt buộc cho việc nhỏ, vì có công cụ không cần viết mã. Với dự án tùy chỉnh hoặc quy mô lớn, kỹ năng lập trình, ví dụ Python, giúp linh hoạt và kiểm soát tốt hơn.
Có nên vượt qua CAPTCHA hay chặn bot để lấy dữ liệu không?
Không. Các rào cản đó cho thấy chủ website không muốn bị thu thập tự động, và vượt qua có thể vi phạm điều khoản hoặc pháp luật. Hãy liên hệ chủ website, dùng API hoặc tìm nguồn dữ liệu khác.
Làm sao để tránh gây hại cho website nguồn?
Giới hạn tần suất, nghỉ giữa các yêu cầu, lưu đệm kết quả, dừng khi gặp lỗi 429 hoặc dấu hiệu quá tải, nhận diện chương trình bằng User-Agent có thông tin liên hệ và chỉ lấy dữ liệu thật sự cần.
Kết luận và bước tiếp theo
Web scraping là công cụ hữu ích để biến thông tin công khai thành dữ liệu phân tích, nhưng giá trị thật đến từ việc dùng đúng cách: ưu tiên nguồn chính thức, tôn trọng robots.txt và điều khoản, tránh dữ liệu cá nhân không cần thiết, giới hạn tần suất và kiểm tra chất lượng. Nếu không chắc về pháp lý, hãy dừng lại và hỏi chuyên gia trước khi triển khai quy mô lớn.
Vidco Group có thể hỗ trợ
Nếu bạn cần tư vấn nghiên cứu thị trường, theo dõi SEO hoặc kết hợp dữ liệu vào chiến lược marketing mà không vi phạm quy định, Vidco Group có thể hỗ trợ lựa chọn nguồn dữ liệu và công cụ phù hợp. Tìm hiểu thêm về data-driven marketing và dịch vụ AI marketing, hoặc liên hệ để trao đổi nhu cầu.
Nguồn tham khảo
- IETF RFC 9309: Robots Exclusion Protocol
- Google Search Central: Introduction to robots.txt
- Beautiful Soup Documentation
- Scrapy Documentation
- MDN: HTTP 429 Too Many Requests
- Bộ Công an: Luật Bảo vệ dữ liệu cá nhân có hiệu lực từ 01/01/2026
Cập nhật: tháng 10/2026