Website agent-ready là gì? Đó là website được chuẩn bị để các AI agent (trợ lý AI tự đọc trang, so sánh, điền form, thậm chí thao tác thay người dùng) hiểu nội dung và hoàn thành việc trên đó mà không bị kẹt. Cách tối ưu website cho AI agent cốt lõi là: cho phép đúng bot truy cập, nội dung có sẵn trong HTML, dùng HTML ngữ nghĩa và nhãn truy cập (accessibility) rõ ràng, form và nút bấm đơn giản, bố cục ổn định, dữ liệu có cấu trúc, và theo dõi bằng log máy chủ. Các chuẩn mới như llms.txt hay WebMCP là phần bổ sung, không thay thế nền tảng này.
Mục lục
- Agent-ready khác gì tối ưu để AI trích dẫn?
- Hai nhóm agent: đọc thông tin và thao tác thay người dùng
- Cho phép đúng bot: robots.txt và các user-agent chính
- Nội dung và HTML mà agent đọc được
- Giúp agent thao tác: form, nút, nhãn, bố cục
- Dữ liệu có cấu trúc, llms.txt và WebMCP
- Lighthouse Agentic Browsing kiểm tra gì?
- Checklist agent-ready 12 điểm
- Rủi ro và giới hạn: bảo mật, quyền kiểm soát, đo lường
- Ví dụ minh họa: website đặt lịch của một phòng khám nha khoa (giả định)
- Câu hỏi thường gặp
- Nguồn tham khảo
Agent-ready khác gì tối ưu để AI trích dẫn?
Hai khái niệm giao nhau nhưng không giống nhau:
- Tối ưu để AI trích dẫn (GEO/AEO): mục tiêu là nội dung của bạn được chọn làm nguồn khi AI trả lời câu hỏi. Trọng tâm là nội dung rõ ràng, uy tín, dễ trích. Bài tối ưu website cho AI đã trình bày checklist cho hướng này.
- Agent-ready: mục tiêu là AI agent có thể làm việc trên website: tìm đúng trang, so sánh thông tin, điền form, đặt lịch, thêm vào giỏ. Trọng tâm là khả năng thao tác và độ ổn định của giao diện.
Nếu agent là “khách hàng mới” thì tối ưu trích dẫn giúp bạn được nhắc đến, còn agent-ready giúp bạn không làm mất khách khi họ nhờ agent làm thay. Để hiểu agent khác chatbot ở điểm nào, xem AI agent là gì.
Lưu ý quan trọng: lĩnh vực này đang thay đổi nhanh, nhiều chuẩn còn ở giai đoạn đề xuất hoặc thử nghiệm. Bài viết cố gắng tách rõ điều đã có tài liệu chính thức và điều còn đang phát triển.
Hai nhóm agent: đọc thông tin và thao tác thay người dùng
Về mặt thực hành, bạn nên chia agent thành hai nhóm vì nhu cầu của chúng khác nhau. Đây là cách phân loại để dễ lập kế hoạch, không phải thuật ngữ chuẩn hóa.
| Tiêu chí | Agent đọc thông tin | Agent thao tác |
|---|---|---|
| Việc làm | Tải trang, đọc, tóm tắt, so sánh | Điều khiển trình duyệt: bấm, nhập, gửi form |
| Cần gì từ website | HTML có nội dung thật, tốc độ phản hồi, quyền truy cập | Nút và form rõ ràng, nhãn đúng, bố cục ổn định, ít bước chặn |
| Điểm hay hỏng | Nội dung chỉ hiện sau JavaScript, bị chặn bot, trang quá nặng | Popup che nút, CAPTCHA, form thiếu nhãn, nút chỉ là hình ảnh |
| Ví dụ nhu cầu | “So sánh 3 gói dịch vụ này” | “Đặt lịch hẹn vào thứ Bảy” |
| Công cụ kiểm tra | Tải trang không bật JS, xem log máy chủ | Kiểm tra cây accessibility, thử quy trình đặt lịch bằng bàn phím |
Cho phép đúng bot: robots.txt và các user-agent chính
Bước đầu tiên là chắc chắn bạn không vô tình chặn những bot bạn muốn. Hãy mở file robots.txt (xem file robots.txt là gì) và tường lửa/CDN để kiểm tra. Theo tài liệu của OpenAI, hiện có ba user-agent chính:
| User-agent | Vai trò theo tài liệu OpenAI | Gợi ý quyết định |
|---|---|---|
| OAI-SearchBot | Đưa website vào kết quả trong tính năng tìm kiếm của ChatGPT | Cho phép nếu muốn xuất hiện trong ChatGPT Search |
| GPTBot | Thu thập nội dung phục vụ huấn luyện mô hình nền | Quyết định theo chính sách nội dung của bạn; tách biệt với việc được hiển thị |
| ChatGPT-User | Dùng cho một số hành động do người dùng khởi tạo trong ChatGPT và Custom GPT | Theo OpenAI, vì hành động do người dùng khởi tạo nên quy tắc robots.txt có thể không áp dụng |
Hai điểm đáng nhớ. Thứ nhất, việc cho phép bot tìm kiếm và việc cho phép bot huấn luyện là hai quyết định riêng; bạn có thể chọn khác nhau. Thứ hai, robots.txt chỉ là chỉ dẫn lịch sự cho crawler tuân thủ. Theo Google, nó không phải cơ chế giữ trang khỏi kết quả tìm kiếm; muốn kiểm soát thật sự cần noindex, mật khẩu hoặc xóa nội dung. Với agent hoạt động theo yêu cầu của người dùng, như Google mô tả về nhóm “user-triggered fetchers”, các công cụ này chạy khi người dùng chủ động kích hoạt, nên không giống crawler tự động.
Nhiều website chặn nhầm bot ở lớp WAF/CDN dù robots.txt cho phép; dấu hiệu là log có nhiều mã 403 hoặc 429 cho user-agent của AI. Xem thêm CDN là gì.
Nội dung và HTML mà agent đọc được
1. Nội dung quan trọng phải có trong HTML ban đầu
Không phải agent nào cũng chạy JavaScript. Theo tài liệu JavaScript SEO của Google, server-side rendering hoặc pre-rendering vẫn hữu ích vì không phải bot nào cũng chạy được JavaScript. Hãy tự kiểm tra bằng cách xem “view source” hoặc dùng lệnh tải trang thô: nếu giá, thông số, địa chỉ, giờ mở cửa không xuất hiện, agent đọc sẽ thấy trang trống.
2. Dùng HTML ngữ nghĩa
Dùng đúng thẻ tiêu đề (h1, h2, h3), danh sách, bảng cho dữ liệu dạng bảng, thẻ nav, main, footer. Bảng giá nên là thẻ table thật chứ không phải ảnh. Thông tin liên hệ nên là văn bản, không chỉ nằm trong banner.
3. Liên kết là thẻ a có href
Google nêu rõ chỉ khám phá liên kết nếu chúng là thẻ a có thuộc tính href. Các “nút” điều hướng dùng thẻ div có sự kiện click là điểm mù của cả crawler lẫn agent.
4. URL ổn định, có ý nghĩa
Mỗi sản phẩm, dịch vụ, bài viết có URL riêng và không đổi. Với ứng dụng một trang, dùng History API thay vì đường dẫn dạng dấu thăng theo khuyến nghị của Google.
5. Thông tin trả lời thẳng, đầy đủ và nhất quán
Agent so sánh nhà cung cấp dựa vào thông tin bạn công bố: phạm vi dịch vụ, điều kiện, thời gian xử lý, chính sách hoàn/hủy, cách liên hệ. Nếu thông tin thiếu hoặc mâu thuẫn giữa các trang, agent có thể bỏ qua hoặc diễn giải sai. Đừng công bố số liệu bạn không thể chứng minh.
6. Tốc độ và độ ổn định
Trang chậm hoặc nhảy bố cục làm agent thao tác sai vị trí, và làm người dùng thật khó chịu. Theo web.dev, ngưỡng LCP tốt là 2,5 giây trở xuống ở phân vị 75. Xem Core Web Vitals là gì và cách tăng tốc website WordPress.
Giúp agent thao tác: form, nút, nhãn, bố cục
Agent điều khiển trình duyệt thường đọc “cây accessibility” (cùng nguồn thông tin mà trình đọc màn hình dùng) để biết phần tử nào bấm được, tên là gì. Vì vậy, làm website thân thiện với người khuyết tật cũng đồng thời giúp agent. Thực hành cụ thể:
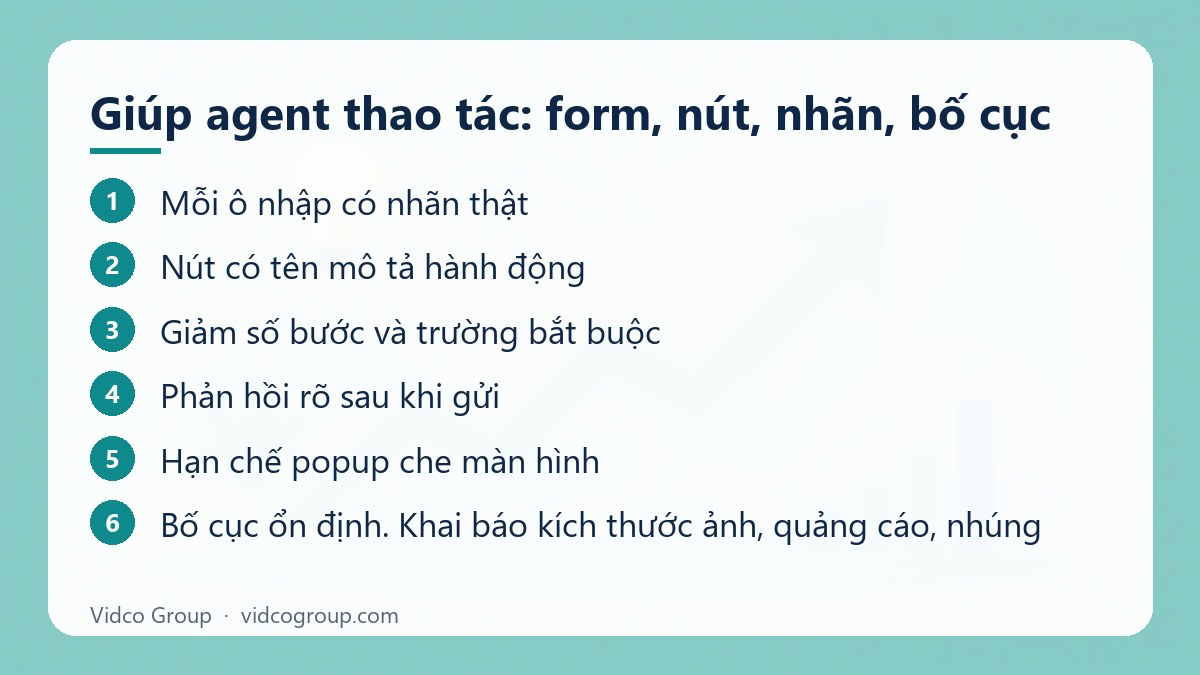
- Mỗi ô nhập có nhãn thật. Dùng thẻ label gắn với ô nhập thay vì chỉ để chữ mờ trong ô (placeholder). Đặt tên trường rõ: “Họ và tên”, “Số điện thoại”, “Ngày hẹn”.
- Nút có tên mô tả hành động. “Đặt lịch hẹn” tốt hơn “Gửi” hoặc biểu tượng trơn. Nút dùng thẻ button, không dùng ảnh hay div.
- Giảm số bước và trường bắt buộc. Form dài nhiều bước dễ làm agent (và người dùng) bỏ dở. Chỉ hỏi thông tin cần thiết.
- Phản hồi rõ sau khi gửi. Trang cảm ơn hoặc thông báo thành công bằng văn bản, mã trạng thái nhất quán, để agent xác nhận việc đã xong.
- Hạn chế popup che màn hình. Popup đăng ký email, banner cookie lớn, chat bật tự động thường chặn tương tác. Chúng phải đóng được bằng một thao tác và không xuất hiện lặp lại.
- Bố cục ổn định. Khai báo kích thước ảnh, quảng cáo, nhúng; tránh nội dung đẩy nút đi chỗ khác ngay khi sắp bấm. Đây là chỉ số CLS.
- Bàn phím dùng được. Có thể Tab qua các phần tử theo thứ tự hợp lý và kích hoạt bằng Enter; đây là phép thử rẻ nhưng hiệu quả.
- Cân nhắc CAPTCHA. CAPTCHA là rào cản có chủ đích với bot. Với các hành động rủi ro cao (thanh toán, tạo tài khoản), việc giữ biện pháp chống lạm dụng là hợp lý; hãy chủ động quyết định đâu là nơi cần xác minh và đâu là nơi nên bỏ để giảm ma sát với người dùng thật.
Dữ liệu có cấu trúc, llms.txt và WebMCP
Dữ liệu có cấu trúc (schema)
Schema.org giúp máy hiểu thực thể: tổ chức, sản phẩm, dịch vụ, sự kiện, địa điểm, câu hỏi thường gặp. Đây là nền tảng ổn định và có tài liệu rõ ràng; xem schema markup là gì. Hãy đảm bảo dữ liệu có cấu trúc khớp với nội dung hiển thị, vì sai lệch gây mất tin cậy.
llms.txt: có ích, đừng kỳ vọng thần kỳ
llms.txt là đề xuất của Jeremy Howard (đăng ngày 3/9/2024) về một file markdown ở thư mục gốc, gồm tiêu đề H1, phần tóm tắt và danh sách liên kết có chú thích, nhằm giúp agent hiểu website. Theo trang llmstxt.org, đây chưa phải chuẩn chính thức, dù nhiều website đã triển khai. Về phía Google Search, tài liệu “AI features and your website” (cập nhật 10/12/2025) viết rằng bạn không cần tạo thêm file máy đọc được, file văn bản cho AI hay markup mới để xuất hiện trong AI Overviews và AI Mode, và không có yêu cầu hay tối ưu đặc biệt nào khác; trang này không nhắc tên llms.txt, nhưng tinh thần là không bắt buộc. Trong khi đó Lighthouse coi llms.txt là một tín hiệu tùy chọn cho agent trình duyệt. Vì vậy hãy xem nó là bước rẻ, có thể làm, chứ không phải điều kiện sống còn. Nếu làm, file phải chính xác, ngắn gọn và được cập nhật cùng nội dung. Tránh liệt kê trang cũ hoặc trang đã gỡ.
WebMCP: hướng thử nghiệm
Theo tài liệu của Chrome, WebMCP là chuẩn web được đề xuất giúp website công bố các “công cụ” có cấu trúc cho AI agent, thay vì để agent đoán qua giao diện. Có hai cách: API lệnh (imperative) bằng JavaScript và API khai báo (declarative) bằng cách chú thích form HTML. Hiện nó ở dạng thử nghiệm origin trial bắt đầu từ Chrome 149 hoặc bật qua cờ cục bộ trong môi trường phát triển, và đặc tả còn thay đổi. Tài liệu cũng nêu giới hạn: được thiết kế chủ yếu cho quy trình trình duyệt có người giám sát, giao diện rất phức tạp có thể cần tái cấu trúc, và trình duyệt phải truy cập trang mới biết trang có công cụ gọi được hay không.
Khuyến nghị thực tế: nếu website của bạn có quy trình giá trị cao (đặt lịch, báo giá, tra cứu đơn), hãy để đội kỹ thuật thử nghiệm ở môi trường riêng. Với website giới thiệu thông thường, nên tập trung nền tảng ở các phần trên trước.
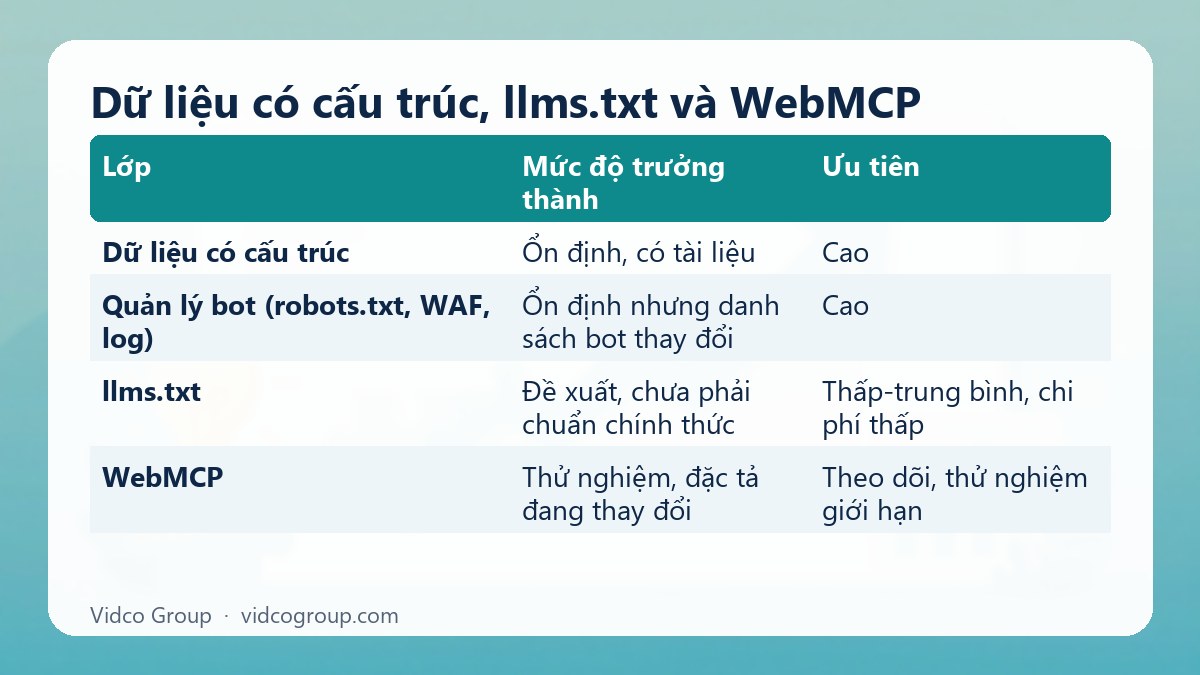
| Lớp | Mức độ trưởng thành | Ưu tiên |
|---|---|---|
| HTML ngữ nghĩa, form có nhãn, tốc độ | Chuẩn đã ổn định | Cao nhất: giúp cả người dùng, SEO và agent |
| Dữ liệu có cấu trúc schema.org | Ổn định, có tài liệu | Cao |
| Quản lý bot (robots.txt, WAF, log) | Ổn định nhưng danh sách bot thay đổi | Cao |
| llms.txt | Đề xuất, chưa phải chuẩn chính thức | Thấp-trung bình, chi phí thấp |
| WebMCP | Thử nghiệm, đặc tả đang thay đổi | Theo dõi, thử nghiệm giới hạn |
Lighthouse Agentic Browsing kiểm tra gì?
Chrome đã bổ sung một nhóm kiểm tra “Agentic Browsing” trong Lighthouse. Theo tài liệu chính thức của Chrome for Developers, nhóm này gồm các vùng sau:
| Vùng kiểm tra | Nội dung theo tài liệu |
|---|---|
| Tích hợp WebMCP | Theo dõi việc đăng ký công cụ, cả công cụ khai báo trong HTML lẫn công cụ lập trình bằng JavaScript |
| Khả năng truy cập dành cho agent | Tên và nhãn, tính toàn vẹn của cây accessibility, mức độ hiển thị của phần tử |
| Ổn định và khả năng khám phá | Cumulative Layout Shift và sự hiện diện của llms.txt ở thư mục gốc |
Điểm đặc biệt: nhóm này không dùng thang điểm 0-100 mà hiển thị tỷ lệ phân số số kiểm tra đạt, kèm trạng thái đạt/không đạt cho từng mục. Hãy dùng nó như danh sách việc cần xem, không phải điểm số để khoe, và nhớ rằng đây là bộ kiểm tra riêng, không phải yếu tố xếp hạng Google. Giao diện và danh sách kiểm tra có thể thay đổi theo phiên bản Lighthouse.
Checklist agent-ready 12 điểm
| # | Việc cần kiểm tra | Cách kiểm tra | Đạt khi |
|---|---|---|---|
| 1 | robots.txt không chặn nhầm bot mong muốn | Mở /robots.txt, đối chiếu chính sách | Quy tắc khớp quyết định của bạn |
| 2 | WAF/CDN không chặn bot hợp lệ | Xem log: mã 403/429 theo user-agent | Bot cho phép nhận mã 200 |
| 3 | Nội dung chính có trong HTML gốc | View source, tải trang không bật JavaScript | Giá, dịch vụ, liên hệ hiển thị được |
| 4 | Liên kết là thẻ a có href | Kiểm tra điều hướng và nút chuyển trang | Không phụ thuộc sự kiện click thuần |
| 5 | Tiêu đề và cấu trúc ngữ nghĩa đúng | Xem outline h1-h3 | Một h1, phân cấp hợp lý |
| 6 | Form có nhãn và nút rõ | Quét bằng trình đọc màn hình hoặc cây accessibility | Mọi ô và nút có tên mô tả |
| 7 | Quy trình chính dùng được bằng bàn phím | Tab và Enter từ đầu đến cuối | Hoàn thành mà không cần chuột |
| 8 | Không popup chặn quy trình | Thử trên thiết bị mới, ẩn danh | Đóng được dễ, không bật lặp |
| 9 | Bố cục ổn định (CLS thấp) | PageSpeed Insights, Lighthouse | Không nhảy bố cục khi tải |
| 10 | Dữ liệu có cấu trúc khớp nội dung | Công cụ kiểm tra dữ liệu có cấu trúc | Không lỗi, không sai lệch |
| 11 | Thông tin điều kiện, chính sách đầy đủ, nhất quán | Đọc lại các trang giá, hoàn/hủy, liên hệ | Không mâu thuẫn, ngày cập nhật rõ |
| 12 | Có theo dõi truy cập của bot và agent | Phân tích log máy chủ, báo cáo nguồn giới thiệu | Biết bot nào ghé, trang nào được đọc |
Rủi ro và giới hạn: bảo mật, quyền kiểm soát, đo lường
Bảo mật và lạm dụng
Mở cửa cho agent không có nghĩa bỏ kiểm soát. Giữ nguyên xác thực, phân quyền và giới hạn tốc độ cho hành động nhạy cảm. Đừng đặt dữ liệu riêng tư, bí mật hay khu vực quản trị ở nơi truy cập được công khai, kể cả khi bạn kỳ vọng chúng không bị tìm thấy. Nên lưu ý rằng nội dung trên trang cũng có thể bị lợi dụng để cố điều khiển agent (kiểu “chèn chỉ dẫn độc hại”); đây là rủi ro đang được cộng đồng bảo mật bàn luận, và trách nhiệm chính thuộc về nhà phát triển agent, nhưng chủ website không nên chèn chỉ dẫn ẩn nhắm vào AI vì có thể vi phạm chính sách của công cụ tìm kiếm và làm mất niềm tin.
Đo lường
Phần lớn công cụ phân tích dựa trên JavaScript ở trình duyệt, nên có thể không thấy bot hoặc agent. Log máy chủ là nguồn đáng tin hơn để biết ai ghé trang. Với agent điều khiển trình duyệt thật, lượt truy cập có thể xuất hiện lẫn với người dùng; hãy theo dõi sự bất thường ở tỷ lệ thoát, thời gian trên trang và lỗi form. Chưa có phương pháp đo lường chuẩn hóa, nên hãy diễn giải thận trọng và không cam kết con số.
Ví dụ minh họa: website đặt lịch của một phòng khám nha khoa (giả định)
Đây là ví dụ giả định để minh họa các bước, không phải khách hàng thật hay kết quả đo được. Một phòng khám nha khoa có website đặt lịch. Người dùng nhờ agent: “Tìm phòng khám nha khoa gần Cầu Giấy mở cửa thứ Bảy và đặt lịch lấy cao răng”.
| Bước agent làm | Vấn đề thường gặp | Cách sửa |
|---|---|---|
| Tìm giờ mở cửa và địa chỉ | Giờ mở cửa nằm trong ảnh banner | Viết thành văn bản và đánh dấu schema LocalBusiness phù hợp |
| Đọc danh sách dịch vụ | Dịch vụ tải bằng JavaScript sau khi cuộn | Render sẵn trong HTML, mỗi dịch vụ có URL riêng |
| Mở form đặt lịch | Form hiện sau popup, nút “Gửi” không rõ | Form có trang riêng, nút “Đặt lịch hẹn” |
| Điền họ tên, số điện thoại, ngày hẹn | Ô ngày dùng thư viện lịch tùy biến không dùng được bàn phím | Dùng ô nhập ngày chuẩn hoặc bổ sung hỗ trợ bàn phím và nhãn |
| Xác nhận | Sau khi gửi chỉ có hiệu ứng, không có chữ | Hiển thị thông báo bằng văn bản “Đã nhận yêu cầu đặt lịch” |
Lưu ý với lĩnh vực y tế: thông tin dịch vụ cần tuân thủ quy định quảng cáo y tế hiện hành, không hứa hẹn kết quả điều trị; hãy kiểm tra văn bản hiện hành. Ví dụ này không có ý nói agent đặt lịch thay khách là việc mọi phòng khám nên mở ngay; việc xác nhận lịch vẫn nên có người rà soát.
Câu hỏi thường gặp
Website agent-ready là gì?
Là website mà AI agent có thể đọc nội dung và thực hiện hành động như tìm thông tin, so sánh, điền form, đặt lịch mà không bị kẹt. Nền tảng gồm HTML ngữ nghĩa, nội dung có sẵn trong HTML, form có nhãn, bố cục ổn định và kiểm soát bot hợp lý.
Làm thế nào để tối ưu website cho AI agent?
Kiểm tra quyền truy cập của bot (robots.txt, tường lửa), đảm bảo nội dung chính có trong HTML, dùng thẻ ngữ nghĩa và nhãn accessibility, làm form đơn giản, tránh popup chặn, bổ sung dữ liệu có cấu trúc và theo dõi log máy chủ. Các chuẩn như llms.txt và WebMCP có thể thử thêm sau.
Agent-ready có phải là GEO/AEO không?
Không hoàn toàn. GEO/AEO nhắm đến việc được AI trích dẫn khi trả lời. Agent-ready nhắm đến việc agent thao tác được trên website. Hai hướng bổ trợ nhau và dùng chung nhiều nền tảng như nội dung rõ ràng, tốc độ và dữ liệu có cấu trúc.
Có bắt buộc phải có llms.txt không?
Không. Đây là đề xuất, chưa phải chuẩn chính thức, và Google Search Central nói bạn không cần file văn bản riêng cho AI để xuất hiện trong AI Overviews hay AI Mode. Lighthouse kiểm tra sự có mặt của nó như một tín hiệu cho agent trình duyệt, nên nếu có thể làm với chi phí thấp, hãy giữ file chính xác và cập nhật.
WebMCP là gì và đã dùng được chưa?
WebMCP là chuẩn web đề xuất để website công bố công cụ có cấu trúc cho AI agent. Theo tài liệu của Chrome, nó đang ở dạng origin trial từ Chrome 149 và đặc tả còn thay đổi, nên phù hợp để thử nghiệm có kiểm soát hơn là triển khai đại trà.
Chặn GPTBot có làm website biến mất khỏi ChatGPT không?
Theo tài liệu của OpenAI, GPTBot phục vụ huấn luyện còn OAI-SearchBot phục vụ tính năng tìm kiếm của ChatGPT, nên chặn GPTBot không đồng nghĩa chặn OAI-SearchBot. Tuy vậy, chính sách bot thay đổi, hãy kiểm tra trang tài liệu chính thức khi cấu hình.
Làm sao biết agent nào đang truy cập website của tôi?
Xem log máy chủ hoặc log CDN, lọc theo user-agent và địa chỉ IP do nhà cung cấp công bố. Công cụ phân tích dùng JavaScript thường không thấy bot. Agent điều khiển trình duyệt thật có thể khó phân biệt với người dùng, nên cần diễn giải thận trọng.
Mở website cho agent có rủi ro gì?
Rủi ro gồm lạm dụng form, tải máy chủ, lộ dữ liệu nếu cấu hình sai và các thao tác ngoài ý muốn. Hãy giữ xác thực, phân quyền, giới hạn tốc độ và xác nhận bước cuối cho các hành động nhạy cảm như thanh toán hoặc thay đổi dữ liệu.
Kết luận và bước tiếp theo
Agent-ready không phải một plugin cài một lần mà là kết quả của việc làm website tốt hơn cho mọi đối tượng: người dùng, công cụ tìm kiếm và agent. Hãy bắt đầu bằng checklist 12 điểm, sửa các lỗi nền tảng trước, rồi mới thử các chuẩn mới. Rà soát lại mỗi quý vì lĩnh vực này thay đổi nhanh.
Vidco Group có thể hỗ trợ: nếu bạn muốn rà soát kỹ thuật cho website, từ nội dung, SEO đến cấu trúc form và tốc độ, hoặc xây mới website theo hướng này, hãy xem dịch vụ thiết kế website và dịch vụ SEO, hoặc liên hệ để trao đổi phạm vi phù hợp.
Nguồn tham khảo
- Chrome for Developers: WebMCP
- Chrome for Developers: Lighthouse agentic browsing scoring
- OpenAI: Overview of OpenAI crawlers
- Google Search Central: Google’s crawlers and fetchers
- Google Search Central: JavaScript SEO basics
- Google Search Central: AI features and your website
- llmstxt.org: The llms.txt proposal
Cập nhật: tháng 10/2026