RAG là gì? RAG (Retrieval-Augmented Generation, tạm dịch “sinh văn bản có tăng cường truy xuất”) là kỹ thuật cho mô hình ngôn ngữ lớn (LLM) tra cứu thông tin từ nguồn dữ liệu bên ngoài trước khi trả lời, thay vì chỉ dựa vào những gì đã học trong quá trình huấn luyện. Nhờ vậy câu trả lời có thể bám sát tài liệu thật, cập nhật hơn và có thể dẫn nguồn.
Với người làm marketing, RAG là một trong những cơ chế nền giúp giải thích vì sao các công cụ tìm kiếm AI và chatbot lại trích dẫn một số trang web mà bỏ qua trang khác. Bài này giải thích RAG là gì, hoạt động ra sao, điểm yếu, và những việc thực tế để nội dung website dễ được truy xuất và trích dẫn hơn trong bối cảnh SEO và GEO (Generative Engine Optimization). Chúng tôi phân biệt rõ điều đã có tài liệu chính thức và điều là suy luận kinh nghiệm.
Mục lục
- RAG ra đời từ đâu?
- Vì sao LLM cần RAG?
- RAG hoạt động như thế nào?
- Các thành phần của một hệ thống RAG
- RAG so với fine-tuning và prompt thuần
- Điểm yếu của RAG
- RAG và SEO/GEO: người làm nội dung cần biết gì?
- Ví dụ giả định: viết lại một trang để dễ được truy xuất
- Ứng dụng RAG trong doanh nghiệp
- Lỗi và hiểu lầm thường gặp
- Lợi ích của RAG đối với doanh nghiệp
- Cách đánh giá một hệ thống RAG
- Các biến thể và xu hướng của RAG
- Câu hỏi thường gặp
- Nguồn tham khảo
RAG ra đời từ đâu?
Thuật ngữ RAG được đặt trong bài báo “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks” của Patrick Lewis và cộng sự, đăng trên arXiv ngày 22/05/2020 và được nhận tại hội nghị NeurIPS 2020. Nhóm tác giả kết hợp một mô hình sinh văn bản đã huấn luyện sẵn (bộ nhớ “tham số”) với một chỉ mục vector của Wikipedia (bộ nhớ “phi tham số”) được truy cập bằng bộ truy xuất nơ-ron. Họ báo cáo mô hình đạt kết quả tốt nhất lúc đó trên các tác vụ hỏi đáp mở và tạo ra văn bản cụ thể, đa dạng, chính xác hơn so với các mô hình chỉ dựa vào tham số.
Từ ý tưởng nghiên cứu đó, RAG trở thành mẫu thiết kế phổ biến cho chatbot doanh nghiệp, trợ lý AI và các công cụ tìm kiếm có phần trả lời tổng hợp. Cách triển khai hiện nay đa dạng hơn bài báo gốc rất nhiều, nhưng nguyên lý cốt lõi giữ nguyên: truy xuất tài liệu liên quan rồi mới sinh câu trả lời dựa trên chúng.
Vì sao LLM cần RAG?
LLM lưu kiến thức trong các tham số, nên có ba hạn chế chính mà RAG giúp giảm bớt (chứ không xóa bỏ):
- Kiến thức có điểm dừng. Mô hình chỉ biết dữ liệu đến thời điểm huấn luyện; thông tin mới hơn phải bổ sung qua truy xuất.
- Có thể “bịa” (hallucination). Khi thiếu thông tin, mô hình vẫn có thể tạo câu trả lời nghe hợp lý nhưng sai. Đưa tài liệu thật vào ngữ cảnh làm giảm xác suất này.
- Không biết dữ liệu riêng. Chính sách nội bộ, bảng giá, hồ sơ sản phẩm của doanh nghiệp không có trong dữ liệu huấn luyện công khai.
Về khái niệm LLM, xem thêm LLM dành cho marketer.
RAG hoạt động như thế nào?
Có nhiều biến thể, nhưng một luồng RAG điển hình gồm hai giai đoạn: chuẩn bị dữ liệu và trả lời câu hỏi.
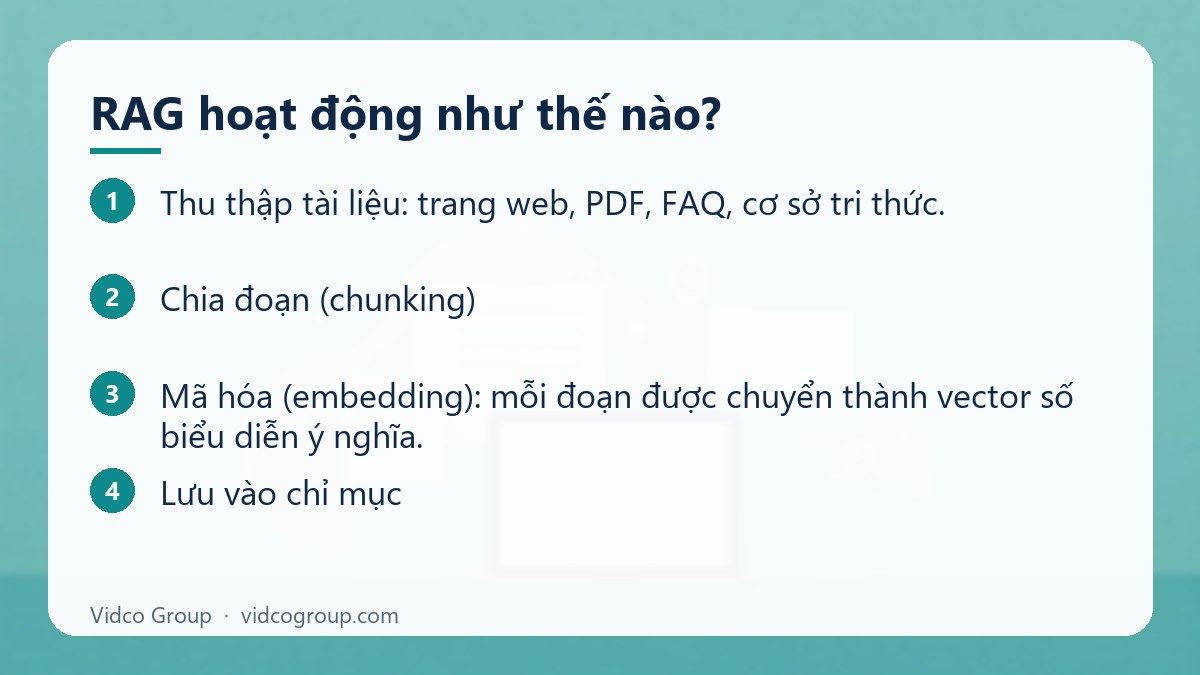
Giai đoạn 1: Chuẩn bị dữ liệu (lập chỉ mục)
- Thu thập tài liệu: trang web, PDF, FAQ, cơ sở tri thức.
- Chia đoạn (chunking): cắt tài liệu thành các đoạn vừa phải, thường mỗi đoạn xoay quanh một ý.
- Mã hóa (embedding): mỗi đoạn được chuyển thành vector số biểu diễn ý nghĩa.
- Lưu vào chỉ mục: vector và văn bản gốc được lưu trong cơ sở dữ liệu vector hoặc hệ thống tìm kiếm.
Giai đoạn 2: Trả lời câu hỏi
- Nhận câu hỏi của người dùng và có thể viết lại, tách thành nhiều truy vấn con.
- Truy xuất (retrieval): tìm các đoạn có vector gần với câu hỏi, thường kết hợp tìm kiếm từ khóa và tìm kiếm theo ngữ nghĩa.
- Xếp hạng lại (re-ranking): chọn những đoạn tốt nhất trong số tìm được.
- Tăng cường (augmentation): đưa các đoạn đó vào prompt cùng câu hỏi.
- Sinh câu trả lời (generation): mô hình tổng hợp câu trả lời dựa trên các đoạn, thường kèm trích dẫn nguồn.
Cách mô tả trên là mô hình tổng quát. Mỗi sản phẩm cụ thể (chatbot nội bộ, công cụ tìm kiếm AI) có thể thay đổi thứ tự hoặc thêm bước, và hầu hết không công bố chi tiết. Vì vậy, đừng coi đây là bản đặc tả chính xác cho bất kỳ công cụ nào.
Các thành phần của một hệ thống RAG
| Thành phần | Vai trò | Điểm cần chú ý | Liên quan đến người làm nội dung |
|---|---|---|---|
| Nguồn dữ liệu | Tài liệu để tra cứu | Dữ liệu cũ, sai hoặc trùng sẽ cho câu trả lời tệ | Nội dung chính xác, cập nhật, có ngày tháng |
| Bộ chia đoạn (chunker) | Cắt tài liệu thành đoạn | Cắt quá nhỏ mất ngữ cảnh; quá lớn gây nhiễu | Mỗi đoạn tự đứng được: tiêu đề rõ, ý trọn vẹn |
| Mô hình embedding | Biến văn bản thành vector | Chất lượng ảnh hưởng độ khớp ngữ nghĩa | Dùng thuật ngữ nhất quán, tránh đại từ mơ hồ |
| Chỉ mục vector / công cụ tìm kiếm | Lưu trữ và tìm đoạn gần nhất | Cần cập nhật khi dữ liệu thay đổi | Trang phải truy cập được và được lập chỉ mục |
| Bộ xếp hạng lại | Chọn đoạn phù hợp nhất | Thêm độ trễ nhưng tăng độ chính xác | Đoạn trả lời trực tiếp dễ được chọn hơn đoạn vòng vo |
| LLM | Tổng hợp câu trả lời | Vẫn có thể diễn giải sai | Viết rõ phạm vi, điều kiện, ngoại lệ |
| Lớp trích dẫn và an toàn | Gắn nguồn, lọc nội dung | Không phải hệ thống nào cũng trích dẫn | Thương hiệu, tác giả, nguồn rõ ràng |
RAG so với fine-tuning và prompt thuần
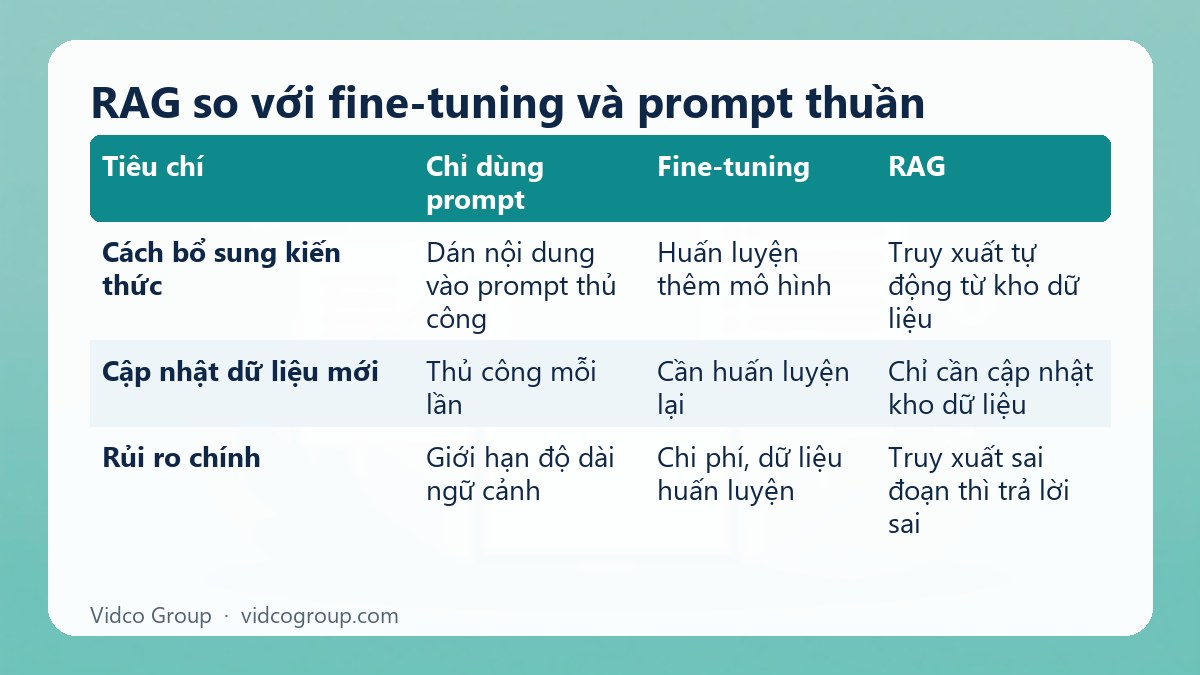
| Tiêu chí | Chỉ dùng prompt | Fine-tuning | RAG |
|---|---|---|---|
| Cách bổ sung kiến thức | Dán nội dung vào prompt thủ công | Huấn luyện thêm mô hình | Truy xuất tự động từ kho dữ liệu |
| Cập nhật dữ liệu mới | Thủ công mỗi lần | Cần huấn luyện lại | Chỉ cần cập nhật kho dữ liệu |
| Khả năng dẫn nguồn | Hạn chế | Khó | Thuận lợi hơn vì biết đoạn nào được dùng |
| Phù hợp | Thử nghiệm nhanh, dữ liệu nhỏ | Thay đổi giọng điệu, định dạng, kỹ năng | Hỏi đáp trên tài liệu thay đổi thường xuyên |
| Rủi ro chính | Giới hạn độ dài ngữ cảnh | Chi phí, dữ liệu huấn luyện | Truy xuất sai đoạn thì trả lời sai |
Ba hướng này không loại trừ nhau; nhiều hệ thống kết hợp chúng. Việc chọn phụ thuộc vào dữ liệu, ngân sách và yêu cầu về độ chính xác.
Điểm yếu của RAG
- Chất lượng truy xuất quyết định chất lượng câu trả lời. Truy xuất sai đoạn hoặc thiếu đoạn quan trọng thì mô hình vẫn có thể trả lời sai.
- Độ trễ và chi phí tăng do thêm bước tìm kiếm và prompt dài hơn.
- Chunking khó. Một câu trả lời cần ghép nhiều đoạn dễ bị bỏ sót.
- Dữ liệu mâu thuẫn. Nếu kho có hai bản chính sách khác nhau, hệ thống có thể chọn nhầm bản.
- Vẫn có thể diễn giải sai. Có tài liệu đúng không đảm bảo mô hình tóm tắt đúng.
- Bảo mật. Nếu kho dữ liệu chứa thông tin nhạy cảm mà không phân quyền, câu trả lời có thể làm lộ dữ liệu.
Vì vậy trong các lĩnh vực nhạy cảm như y tế, tài chính, pháp lý, cần có con người kiểm soát và kiểm tra nguồn. Xem thêm khái niệm YMYL là gì.
RAG và SEO/GEO: người làm nội dung cần biết gì?
Cần tách bạch hai lớp thông tin để không nói quá:
Điều Google nói công khai
Tài liệu của Google về tính năng AI trong Search cho biết AI Overviews và AI Mode dùng kỹ thuật “query fan-out”: gửi nhiều tìm kiếm liên quan trên các chủ đề phụ để tổng hợp câu trả lời, nhờ đó có thể hiển thị tập liên kết rộng và đa dạng hơn. Để xuất hiện, trang không cần yêu cầu bổ sung nào ngoài điều kiện của Search thông thường: được lập chỉ mục và đủ điều kiện hiển thị snippet. Google cũng khẳng định không cần đánh dấu đặc biệt hay tệp riêng cho AI. Các thực hành SEO nền tảng vẫn áp dụng: cho phép thu thập, liên kết nội bộ tốt, trải nghiệm trang tốt, nội dung chủ yếu dạng văn bản, dữ liệu có cấu trúc chính xác.
Google không dùng chữ “RAG” để mô tả sản phẩm của mình trong tài liệu này. Việc liên hệ giữa RAG và AI Overviews là sự tương đồng về nguyên lý (truy xuất rồi tổng hợp), không phải xác nhận chi tiết kiến trúc.
Điều là suy luận thực tế (không phải quy tắc được công bố)
Dựa trên nguyên lý truy xuất theo đoạn, những thói quen viết sau có xu hướng giúp nội dung dễ được trích dẫn hơn. Hãy xem chúng là giả thuyết cần kiểm chứng trong dữ liệu của bạn, không phải công thức đảm bảo:
| Thực hành | Lý do suy luận | Cách làm |
|---|---|---|
| Trả lời trực tiếp ở đầu mỗi mục | Đoạn ngắn, đủ ý dễ được chọn làm ngữ cảnh | Câu đầu của mỗi H2 nêu kết luận, sau đó mới giải thích |
| Mỗi đoạn tự đứng được | Đoạn có thể bị tách khỏi bài khi chunking | Lặp tên chủ thể thay vì “nó”, “điều này” |
| Heading là câu hỏi hoặc mô tả rõ | Khớp ngữ nghĩa với truy vấn của người dùng | H2 dạng “RAG hoạt động thế nào?” thay vì tiêu đề mơ hồ |
| Bảng và danh sách có cấu trúc | Thông tin có tổ chức dễ trích xuất | Dùng bảng so sánh, bước đánh số |
| Dữ kiện có nguồn và ngày | Tăng độ tin cậy và giảm rủi ro thông tin cũ | Dẫn nguồn chính thống, ghi “Cập nhật” |
| Thực thể được gọi tên đầy đủ nhất quán | Giảm nhầm lẫn khi ghép nhiều nguồn | Viết đầy đủ “Google Search Console” ở lần đầu |
| Nội dung dễ thu thập | Không thu thập được thì không vào chỉ mục | Kiểm tra robots.txt, tốc độ, render; xem Googlebot là gì |
Một điều quan trọng: chưa có bằng chứng công khai đáng tin cậy rằng một tệp như llms.txt đảm bảo được trích dẫn. Bạn có thể tìm hiểu ở bài llms.txt nhưng nên coi đây là thử nghiệm, không thay thế nội dung tốt và nền tảng SEO.
Để triển khai bài bản hơn, xem GEO là gì, GEO checklist, LLM SEO và AI Overviews ảnh hưởng SEO thế nào.
Ví dụ giả định: viết lại một trang để dễ được truy xuất
Ví dụ minh họa giả định, không phải khách hàng thật. Một trang dịch vụ có đoạn mở đầu dài 300 chữ nói chung chung về “tầm quan trọng của thương hiệu”, thông tin giá nằm trong ảnh, và câu hỏi thường gặp bị ẩn sau tab. Khi chia đoạn, hệ thống khó tìm được đoạn trả lời trực tiếp.
| Phần | Trước | Sau |
|---|---|---|
| Mở đầu | 300 chữ dẫn dắt chung chung | 2 câu định nghĩa dịch vụ, ai cần, làm gì |
| Quy trình | Đoạn văn liền khối | Danh sách đánh số 5 bước, mỗi bước 1 đến 2 câu |
| Chi phí | Ảnh bảng giá | Bảng HTML các yếu tố ảnh hưởng chi phí; “liên hệ báo giá” nếu chưa công khai |
| FAQ | Ẩn sau tab, câu trả lời mơ hồ | H3 là câu hỏi, đoạn trả lời 2 đến 4 câu, hiển thị sẵn trong HTML |
| Tác giả và ngày | Không có | Tên tác giả, ngày cập nhật, nguồn tham khảo |
Thay đổi này cải thiện trải nghiệm đọc cho người dùng thật. Việc nó có tăng khả năng được trích dẫn trong tìm kiếm AI hay không cần được đo bằng cách tự kiểm tra các truy vấn mục tiêu theo thời gian, không nên hứa trước kết quả.
Ứng dụng RAG trong doanh nghiệp
- Chatbot chăm sóc khách hàng trả lời dựa trên chính sách và catalog của công ty. Xem chatbot AI là gì.
- Trợ lý nội bộ tra cứu quy trình, tài liệu đào tạo, biên bản.
- Công cụ tìm kiếm có trả lời tổng hợp trên website hoặc cổng tri thức.
- Hỗ trợ đội marketing tìm lại thông tin sản phẩm, brief, thương hiệu khi soạn nội dung.
Khi nào nên và không nên dùng RAG
| Nên dùng khi | Không nên (hoặc cần thận trọng) khi |
|---|---|
| Có kho tài liệu thay đổi thường xuyên | Không có người chịu trách nhiệm cập nhật và kiểm tra dữ liệu |
| Cần câu trả lời có nguồn để kiểm chứng | Lĩnh vực rủi ro cao mà không có người kiểm tra cuối |
| Dữ liệu riêng không nằm trong mô hình công khai | Dữ liệu nhạy cảm chưa phân quyền, chưa đánh giá bảo mật |
| Muốn bắt đầu nhỏ, thử nghiệm với một nhóm câu hỏi | Kỳ vọng “trả lời đúng 100%” |
Nếu bạn dự định đưa dữ liệu khách hàng vào hệ thống AI, hãy rà soát quy định bảo vệ dữ liệu cá nhân hiện hành và chính sách của nhà cung cấp trước khi triển khai; đây không phải tư vấn pháp lý, nên tham khảo chuyên gia có thẩm quyền.
Lỗi và hiểu lầm thường gặp
| Hiểu lầm | Thực tế |
|---|---|
| “Có RAG là hết bịa” | RAG giảm nguy cơ nhưng không loại bỏ; mô hình vẫn có thể tóm tắt sai hoặc truy xuất sai |
| “Chỉ cần tải tất cả tài liệu lên là xong” | Dữ liệu bẩn, trùng, mâu thuẫn làm kết quả tệ; cần làm sạch và kiểm soát phiên bản |
| “Làm SEO chuẩn là tự động được AI trích dẫn” | SEO nền tảng là điều kiện cần; việc được trích dẫn còn phụ thuộc truy vấn, đối thủ và cách từng hệ thống chọn nguồn |
| “Có thủ thuật đặc biệt để thao túng AI” | Không có thủ thuật công khai đáng tin; tránh dịch vụ hứa chắc chắn được trích dẫn |
| “Chunk càng nhỏ càng tốt” | Quá nhỏ mất ngữ cảnh; cần thử nghiệm kích thước phù hợp với loại tài liệu |
| “RAG thay thế SEO” | Không; nhiều hệ thống vẫn dựa vào chỉ mục tìm kiếm, nên SEO vẫn là nền tảng |
Lợi ích của RAG đối với doanh nghiệp
| Lợi ích | Giải thích | Điều kiện để đạt được |
|---|---|---|
| Cập nhật kiến thức nhanh | Chỉ cần cập nhật kho tài liệu, không cần huấn luyện lại mô hình | Có quy trình làm mới chỉ mục |
| Giảm nguy cơ bịa thông tin | Mô hình có tài liệu để bám vào | Truy xuất đúng, dữ liệu sạch |
| Dẫn nguồn kiểm chứng | Biết đoạn tài liệu nào được dùng | Giữ liên kết giữa đoạn và tài liệu gốc |
| Tận dụng dữ liệu riêng | Chính sách, hợp đồng, catalog không cần đưa vào huấn luyện | Phân quyền truy cập, bảo mật |
| Chi phí khởi đầu thấp hơn fine-tuning | Không cần huấn luyện mô hình lớn cho mỗi lần đổi dữ liệu | Vẫn tốn chi phí hạ tầng và vận hành lâu dài |
Cách đánh giá một hệ thống RAG có tốt không
Đánh giá RAG gồm hai lớp: chất lượng truy xuất và chất lượng câu trả lời. Một bộ kiểm tra tối thiểu có thể gồm 30 đến 50 câu hỏi thật của người dùng, mỗi câu có đáp án và tài liệu nguồn đã được người có chuyên môn xác nhận.
| Chỉ số | Câu hỏi cần trả lời | Cách đo đơn giản |
|---|---|---|
| Độ phủ truy xuất | Đoạn chứa đáp án có nằm trong các đoạn được lấy ra không? | Tỷ lệ câu hỏi có đoạn đúng trong top vài kết quả |
| Độ bám nguồn | Câu trả lời có được tài liệu hỗ trợ không? | Người kiểm tra đối chiếu từng khẳng định với đoạn nguồn |
| Độ chính xác | Câu trả lời có đúng so với đáp án chuẩn không? | Chấm đúng, sai, thiếu |
| Độ trễ và chi phí | Thời gian và chi phí mỗi câu trả lời là bao nhiêu? | Ghi log hệ thống |
| An toàn dữ liệu | Có lộ thông tin ngoài quyền người dùng không? | Thử với tài khoản có quyền khác nhau |
Đây là khung đánh giá thực hành của chúng tôi, không phải chuẩn bắt buộc; nhiều nhóm kỹ thuật dùng thêm công cụ đánh giá chuyên dụng.
Các biến thể và xu hướng của RAG
- Tìm kiếm lai (hybrid search): kết hợp tìm theo từ khóa và theo ngữ nghĩa để bắt được cả thuật ngữ chính xác lẫn câu hỏi diễn đạt khác.
- Agentic RAG: mô hình tự quyết định khi nào cần tìm, tìm gì, có tìm thêm lần nữa không, thay vì luôn tìm một lần theo luồng cố định. Cách gọi này phổ biến trong cộng đồng kỹ thuật, nhưng định nghĩa chưa thống nhất giữa các nhà cung cấp.
- RAG dựa trên đồ thị tri thức: dùng quan hệ giữa các thực thể để trả lời câu hỏi cần ghép nhiều tài liệu.
- RAG đa phương thức: truy xuất cả hình ảnh, bảng, biểu đồ chứ không chỉ văn bản.
Với người làm nội dung, xu hướng chung là hệ thống ngày càng chia nhỏ câu hỏi thành nhiều truy vấn con, nên nội dung nên trả lời gọn nhiều ý nhỏ thay vì một khối văn bản dài khó tách.
Câu hỏi thường gặp
Embedding và vector database là gì trong RAG?
Embedding là cách biến một đoạn văn thành dãy số biểu diễn ý nghĩa; các đoạn có nghĩa gần nhau cho vector gần nhau. Vector database là nơi lưu các vector này và tìm nhanh những vector gần với câu hỏi.
RAG có cần cơ sở dữ liệu vector không?
Không bắt buộc. Có hệ thống dùng công cụ tìm kiếm từ khóa hoặc kết hợp nhiều cách. Cơ sở dữ liệu vector chỉ là một cách phổ biến để tìm theo ngữ nghĩa.
Khi nào nên chọn fine-tuning thay vì RAG?
Khi bạn cần thay đổi giọng điệu, định dạng đầu ra hoặc kỹ năng ổn định của mô hình hơn là bổ sung kiến thức thay đổi thường xuyên. Nhiều hệ thống kết hợp cả hai.
RAG là gì, nói ngắn gọn?
RAG là kỹ thuật cho AI tra cứu tài liệu liên quan trước khi trả lời, rồi dùng chính tài liệu đó làm cơ sở để viết câu trả lời. Nhờ vậy câu trả lời có thể cập nhật hơn, bám dữ liệu thật và dẫn nguồn được.
RAG khác gì ChatGPT hay các chatbot thông thường?
Chatbot thông thường trả lời chủ yếu từ kiến thức đã huấn luyện. Hệ thống RAG thêm bước truy xuất tài liệu bên ngoài trước khi sinh câu trả lời. Một số sản phẩm chatbot hiện có tích hợp tìm kiếm, nhưng chi tiết cơ chế từng sản phẩm không phải lúc nào cũng được công bố.
RAG có loại bỏ hoàn toàn việc AI bịa thông tin không?
Không. RAG giúp giảm nguy cơ vì mô hình có tài liệu để bám vào, nhưng nếu truy xuất sai, tài liệu sai hoặc mô hình diễn giải sai thì câu trả lời vẫn có thể sai. Cần kiểm tra của con người, đặc biệt ở chủ đề nhạy cảm.
RAG ảnh hưởng gì đến SEO?
RAG không thay thế SEO. Nó nhấn mạnh thêm việc nội dung cần dễ thu thập, rõ ràng theo từng đoạn, có nguồn đáng tin. Google cho biết để xuất hiện trong AI Overviews và AI Mode không có yêu cầu kỹ thuật bổ sung ngoài điều kiện Search thông thường.
Làm sao để nội dung dễ được AI trích dẫn?
Đảm bảo trang được lập chỉ mục, viết câu trả lời trực tiếp ở đầu mỗi mục, mỗi đoạn tự đứng được, dùng bảng và danh sách, dẫn nguồn đáng tin và cập nhật thường xuyên. Không có cách nào đảm bảo chắc chắn được trích dẫn.
Tôi có cần biết lập trình để dùng RAG không?
Để xây hệ thống RAG riêng thường cần kỹ sư hoặc dùng nền tảng có sẵn. Với người làm nội dung, bạn không cần lập trình, nhưng nên hiểu cơ chế để viết nội dung phù hợp và phối hợp với đội kỹ thuật.
RAG có an toàn với dữ liệu doanh nghiệp không?
Phụ thuộc cách triển khai. Cần phân quyền truy cập dữ liệu, kiểm tra điều khoản của nhà cung cấp, ghi log và rà soát quy định bảo vệ dữ liệu hiện hành. Không nên đưa dữ liệu nhạy cảm vào hệ thống chưa được đánh giá bảo mật.
RAG và GEO có phải một không?
Không. RAG là kỹ thuật bên trong hệ thống AI, còn GEO là hoạt động tối ưu nội dung để được hiển thị hoặc trích dẫn trong câu trả lời do AI tạo ra. Hiểu RAG giúp bạn làm GEO có cơ sở hơn.
Kết luận và bước tiếp theo
RAG là cầu nối giữa mô hình ngôn ngữ và kho tri thức bên ngoài. Với người làm SEO và nội dung, bài học thực tế là: nội dung phải dễ thu thập, chính xác, có cấu trúc rõ ràng theo từng đoạn và có nguồn đáng tin. Hãy bắt đầu bằng việc rà soát 10 trang quan trọng nhất: câu trả lời trực tiếp ở đầu mục, FAQ hiển thị, nguồn và ngày cập nhật. Sau đó tự kiểm tra các truy vấn mục tiêu định kỳ để xem nội dung của bạn có được dẫn lại hay không.
Vidco Group có thể hỗ trợ: nếu bạn muốn rà soát nội dung theo hướng SEO và GEO hoặc xây dựng nội dung có cấu trúc dễ được tìm kiếm AI trích dẫn, hãy xem dịch vụ GEO và dịch vụ content SEO của chúng tôi. Vidco Group không cam kết thứ hạng hay lượt trích dẫn cụ thể, vì các hệ thống AI thay đổi liên tục.
Nguồn tham khảo
- Lewis và cộng sự (2020): Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, arXiv:2005.11401
- Google Search Central: AI features and your website
- Google Search Central: Creating helpful, reliable, people-first content
- Google Cloud: What is Retrieval-Augmented Generation (RAG)?
Cập nhật: tháng 10/2026