Googlebot là gì? Googlebot là tên chung của các trình thu thập dữ liệu (crawler) mà Google dùng để truy cập, tải và đọc các trang web nhằm xây dựng chỉ mục tìm kiếm. Hiểu đơn giản, đây là “con bot” đi từ liên kết này sang liên kết khác, đọc nội dung từng trang rồi gửi về hệ thống của Google; trang nào chưa được Googlebot thu thập và lập chỉ mục thì gần như không thể xuất hiện trong kết quả tìm kiếm.
Với người làm SEO, câu hỏi “Googlebot là gì” không chỉ là kiến thức nền. Nó liên quan trực tiếp đến việc bài mới lên Google nhanh hay chậm, vì sao một số trang không được lập chỉ mục, cách phân biệt bot thật với bot giả mạo và khi nào nên (hoặc không nên) chặn bot. Bài viết này tổng hợp từ tài liệu chính thức của Google Search Central, kèm bảng chẩn đoán và checklist áp dụng được ngay.
Mục lục
- Googlebot hoạt động như thế nào?
- Các loại Googlebot và crawler khác của Google
- Googlebot Smartphone và mobile-first indexing
- Cách xác minh Googlebot thật
- Chặn hay cho phép Googlebot: robots.txt và noindex
- Cách theo dõi Googlebot trên website của bạn
- Bảng chẩn đoán: Googlebot không thu thập trang
- Tối ưu để Googlebot thu thập hiệu quả
- Lỗi thường gặp
- Googlebot xử lý JavaScript và render trang
- Ví dụ giả định: site thương mại điện tử 10.000 URL
- Googlebot khác gì Bingbot và các bot AI?
- Câu hỏi thường gặp
- Nguồn tham khảo
Googlebot hoạt động như thế nào?
Quy trình của Google Search gồm ba giai đoạn lớn: thu thập dữ liệu (crawling), lập chỉ mục (indexing) và xếp hạng cùng hiển thị kết quả. Googlebot đảm nhiệm giai đoạn đầu. Nó bắt đầu từ danh sách URL đã biết, lấy từ lần thu thập trước, từ sitemap bạn khai báo và từ các liên kết tìm thấy trên những trang khác. Sau đó nó tải nội dung (HTML, hình, CSS, JavaScript, PDF), tuân theo quy tắc trong tệp robots.txt, và chuyển dữ liệu cho hệ thống xử lý.
Điều quan trọng: thu thập không đồng nghĩa với lập chỉ mục. Một URL có thể được Googlebot truy cập nhưng vẫn không vào chỉ mục vì nội dung trùng lặp, chất lượng thấp, bị noindex hoặc lỗi kỹ thuật. Ngược lại, một URL bị chặn bằng robots.txt vẫn có thể xuất hiện trong kết quả (chỉ có địa chỉ, không có mô tả) nếu có liên kết trỏ đến. Để hiểu rõ hơn về vòng đời này, xem bài Index là gì và Web crawler là gì.
Tốc độ thu thập
Google nêu trong tài liệu rằng Googlebot không nên truy cập site của bạn nhiều hơn một lần mỗi vài giây tính trung bình, dù có thể dao động ngắn hạn. Tốc độ thực tế phụ thuộc vào độ khỏe của máy chủ, mức độ quan trọng và tần suất thay đổi của nội dung. Site lớn cần quan tâm thêm khái niệm crawl budget.
Các loại Googlebot và crawler khác của Google
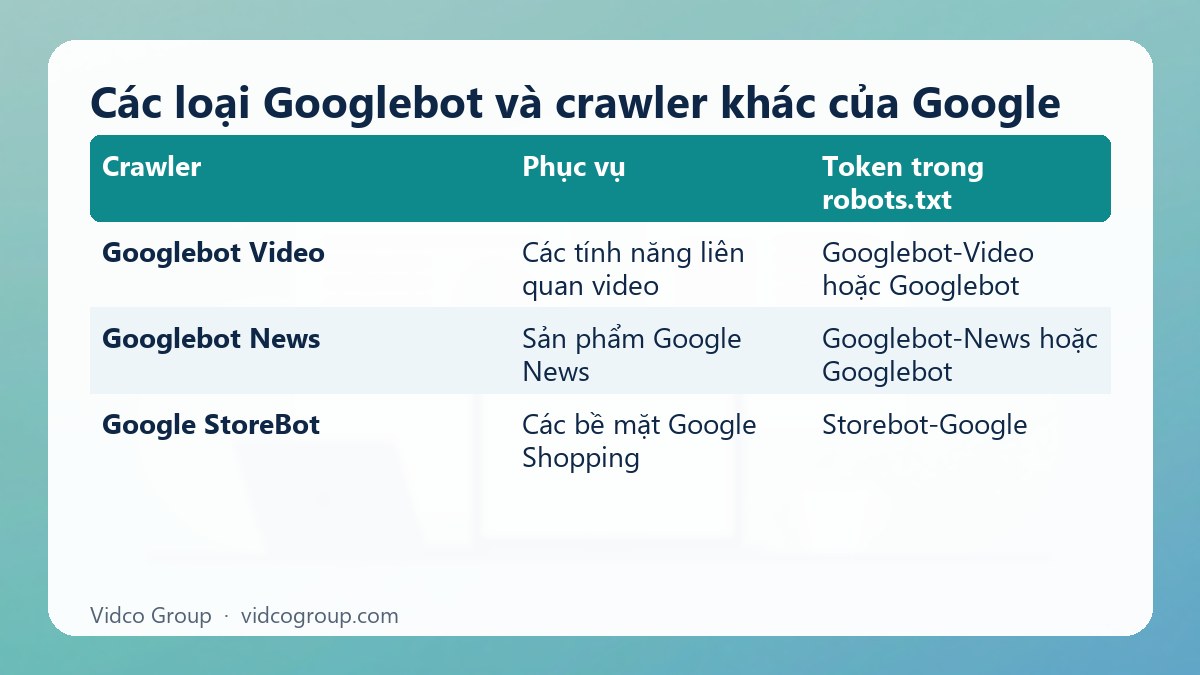
Không chỉ có một “Googlebot”. Theo trang tài liệu về common crawlers của Google, mỗi crawler phục vụ một sản phẩm và có token riêng để dùng trong robots.txt:
| Crawler | Phục vụ | Token trong robots.txt |
|---|---|---|
| Googlebot (Smartphone và Desktop) | Xây chỉ mục cho Google Search; ảnh hưởng Search, Images, Video, News, Discover | Googlebot |
| Googlebot Image | Hình ảnh trong Google Images, Discover và các tính năng hiển thị ảnh | Googlebot-Image hoặc Googlebot |
| Googlebot Video | Các tính năng liên quan video | Googlebot-Video hoặc Googlebot |
| Googlebot News | Sản phẩm Google News | Googlebot-News hoặc Googlebot |
| Google StoreBot | Các bề mặt Google Shopping | Storebot-Google |
| Google-InspectionTool | Công cụ kiểm tra như Rich Result Test, URL Inspection | Google-InspectionTool hoặc Googlebot |
| GoogleOther | Crawler chung cho các nhóm sản phẩm khác của Google | GoogleOther |
| Google-Extended | Kiểm soát việc nội dung có được dùng để huấn luyện các thế hệ mô hình Gemini tương lai | Google-Extended |
Lưu ý: Google-Extended là token điều khiển trong robots.txt, không phải một user agent tách riêng trong log. Danh sách crawler có thể thay đổi, vì vậy hãy đối chiếu trang chính thức trước khi viết quy tắc.
Googlebot Smartphone và mobile-first indexing
Google có hai loại Googlebot chính: Googlebot Smartphone mô phỏng người dùng trên điện thoại, Googlebot Desktop mô phỏng người dùng trên máy tính. Với hầu hết website, Google chủ yếu lập chỉ mục phiên bản di động của nội dung, nên phần lớn yêu cầu thu thập đến từ Googlebot Smartphone. Cả hai cùng tuân theo một token Googlebot trong robots.txt, nên bạn không thể chỉ chặn riêng một loại bằng robots.txt.
Hệ quả thực tế: nếu bản mobile của bạn thiếu nội dung, ẩn liên kết nội bộ hoặc tải chậm so với bản desktop, Google có thể thấy một phiên bản kém hơn trang bạn đang xem trên máy tính. Hãy kiểm tra bằng công cụ URL Inspection trong Google Search Console.
Giới hạn dung lượng tệp
Tài liệu Googlebot của Google nêu: Googlebot thu thập 2MB đầu tiên của một tệp thuộc loại được hỗ trợ và 64MB đầu tiên của tệp PDF; CSS và JavaScript cũng chịu cùng giới hạn. Với HTML thông thường, 2MB là rất lớn, nhưng các trang chèn dữ liệu JSON khổng lồ hoặc nội dung quan trọng nằm quá sâu trong tệp có thể bị cắt. Nguyên tắc: đặt nội dung và liên kết quan trọng sớm trong HTML, giữ tệp gọn.
Cách xác minh Googlebot thật
Bất kỳ ai cũng có thể giả danh user agent “Googlebot” trong request. Google hướng dẫn hai cách xác minh đáng tin cậy:
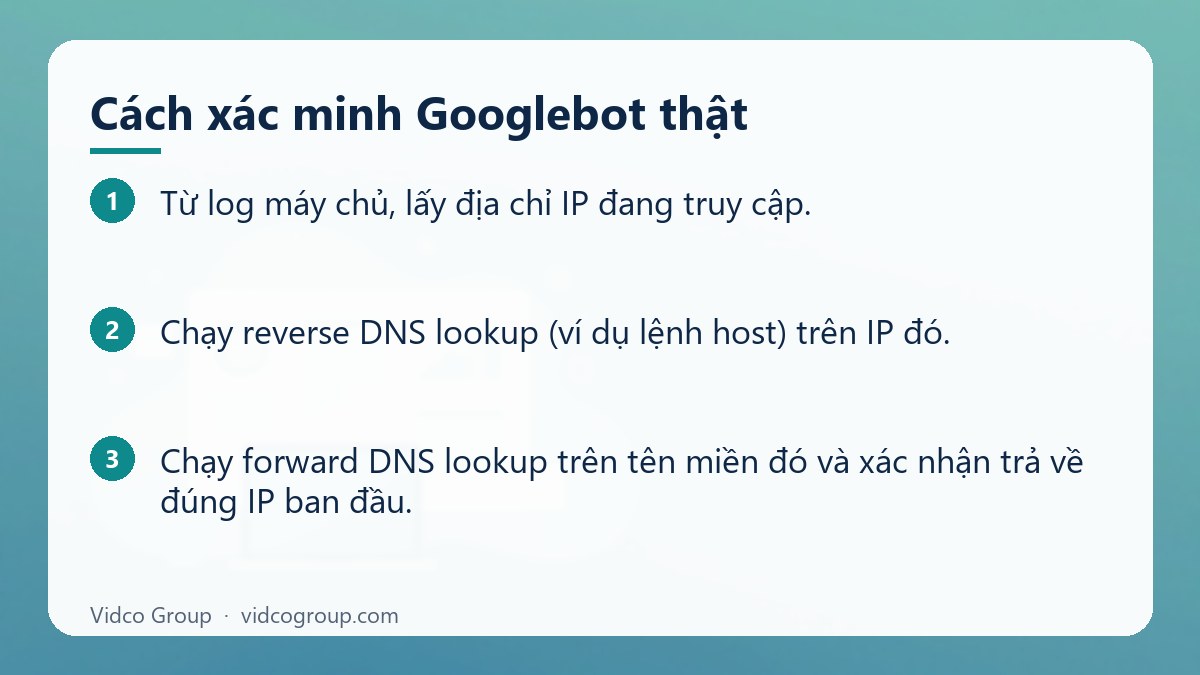
Cách 1: Reverse DNS thủ công
- Từ log máy chủ, lấy địa chỉ IP đang truy cập.
- Chạy reverse DNS lookup (ví dụ lệnh
host) trên IP đó. - Kiểm tra tên miền trả về thuộc googlebot.com, google.com hoặc googleusercontent.com.
- Chạy forward DNS lookup trên tên miền đó và xác nhận trả về đúng IP ban đầu.
Cách 2: Đối chiếu dải IP công bố
Với site có lượng truy cập lớn, so khớp IP với các tệp JSON Google công bố: common-crawlers.json cho Googlebot, special-crawlers.json cho các crawler đặc biệt như AdsBot và các tệp cho user-triggered fetchers. Dải IP dùng định dạng CIDR.
| Loại crawler | Dạng tên miền reverse DNS (theo Google) |
|---|---|
| Common crawlers (Googlebot) | crawl-***-***-***-***.googlebot.com hoặc geo-crawl-…geo.googlebot.com |
| Special-case crawlers | rate-limited-proxy-…google.com |
| User-triggered fetchers | …gae.googleusercontent.com hoặc google-proxy-…google.com |
Nên làm xác minh trước khi chặn IP hoặc tin vào số liệu log, vì nhiều thống kê “Googlebot” thực ra là bot giả. Cách phân tích log chi tiết có ở bài phân tích log crawler.
Chặn hay cho phép Googlebot: robots.txt và noindex
Đây là chỗ nhiều người nhầm nhất. Hai công cụ có mục đích khác nhau:
| Công cụ | Kiểm soát cái gì | Dùng khi | Rủi ro |
|---|---|---|---|
| robots.txt (Disallow) | Việc thu thập (crawl) | Giảm tải cho khu vực không cần crawl: trang lọc, tìm kiếm nội bộ, tài nguyên không cần thiết | URL vẫn có thể được lập chỉ mục nếu có liên kết trỏ đến; Googlebot không đọc được thẻ noindex trên trang bị chặn |
| Thẻ meta robots noindex | Việc lập chỉ mục | Muốn trang không xuất hiện trên Google | Googlebot phải được phép truy cập trang để thấy thẻ này |
| Bảo vệ bằng mật khẩu / đăng nhập | Truy cập thật sự | Nội dung riêng tư, môi trường thử nghiệm | Cần cấu hình đúng, không chỉ dựa vào robots.txt |
| Mã trạng thái 503 hoặc 429 | Làm Google giảm tốc độ thu thập | Khẩn cấp, quá tải máy chủ trong thời gian ngắn | Google khuyến cáo không kéo dài quá 1 đến 2 ngày |
Một quy tắc robots.txt tối thiểu cho phép mọi bot, kèm khai báo sitemap, trông như sau:
User-agent: *
Disallow:
Sitemap: https://tenmiencuaban.com/sitemap.xml
Để chặn một thư mục, ví dụ trang tìm kiếm nội bộ: Disallow: /tim-kiem/. Hãy kiểm thử kỹ trước khi đưa lên, vì một dòng Disallow: / sai chỗ có thể chặn toàn bộ website. Chi tiết xem robots.txt là gì và noindex và các chỉ thị robots.
Khi nào nên chặn Googlebot, khi nào không
- Nên chặn crawl: khu vực vô hạn URL (bộ lọc sắp xếp, phiên tìm kiếm), trang quản trị, tài nguyên gây tải lớn không cần cho hiển thị.
- Không nên chặn: CSS, JavaScript và hình ảnh cần thiết để Google hiểu cách trang hiển thị; trang bạn muốn lên Google; sitemap.
- Muốn gỡ khỏi Google: dùng noindex hoặc xóa trang đúng cách, không chỉ dùng Disallow.
- Không muốn nội dung dùng huấn luyện Gemini: cân nhắc token Google-Extended, và cân nhắc kỹ tác động tới chiến lược hiển thị AI của bạn.
Cách theo dõi Googlebot trên website của bạn
Báo cáo Crawl Stats trong Search Console
Google mô tả báo cáo này gồm các chỉ số: tổng số yêu cầu thu thập, tổng dung lượng tải, thời gian phản hồi trung bình, trạng thái máy chủ (host status), nhóm mã phản hồi (200, 301, 404, 5xx), loại tệp, mục đích thu thập (khám phá hay làm mới) và loại Googlebot. Báo cáo dành cho người dùng nâng cao và chỉ có ở thuộc tính gốc: domain property hoặc URL-prefix property ở cấp gốc.
URL Inspection
Kiểm tra từng URL: Google đã thu thập lần cuối khi nào, bằng loại Googlebot nào, trang có được lập chỉ mục không, và nhìn thấy HTML đã render ra sao. Xem thêm cách kiểm tra Google index.
Log máy chủ
Log cho bạn thấy URL nào bot thật sự gọi, bao nhiêu lần, mã phản hồi gì. Nhớ xác minh IP như phần trên trước khi kết luận.
Bảng chẩn đoán: Googlebot không thu thập trang
| Triệu chứng | Nguyên nhân thường gặp | Cách kiểm tra | Hướng xử lý |
|---|---|---|---|
| Bài mới lên rất chậm | Ít liên kết nội bộ, không có trong sitemap, site mới ít tín hiệu | URL Inspection, kiểm tra sitemap | Gắn liên kết nội bộ từ trang quan trọng, khai báo sitemap, đảm bảo trang không noindex |
| URL bị “Blocked by robots.txt” | Quy tắc Disallow quá rộng | Xem tệp robots.txt và báo cáo lập chỉ mục | Sửa quy tắc, kiểm thử lại |
| Nhiều lỗi 5xx trong Crawl Stats | Máy chủ quá tải, hosting yếu | Crawl Stats, log máy chủ | Nâng hạ tầng, bật cache, xem lại WAF/CDN có chặn bot |
| Thời gian phản hồi tăng cao | Trang nặng, truy vấn chậm | Crawl Stats: average response time | Tối ưu cache, hình ảnh, truy vấn cơ sở dữ liệu |
| Crawl nhiều URL rác | Tham số lọc, phân trang vô hạn, trùng lặp | Log và báo cáo trang không lập chỉ mục | Chuẩn hóa URL, canonical, chặn crawl khu vực không cần |
| Nội dung JavaScript không hiện trong chỉ mục | Nội dung chỉ xuất hiện sau tương tác hoặc lỗi render | URL Inspection, xem HTML đã render | Render phía máy chủ hoặc đưa nội dung quan trọng vào HTML |
| Bot lạ tự nhận là Googlebot | Bot giả mạo | Reverse DNS và forward DNS | Chặn hoặc giới hạn ở tầng máy chủ nếu không xác minh được |
Tối ưu để Googlebot thu thập hiệu quả
- Đảm bảo máy chủ ổn định. Phản hồi nhanh, ít lỗi 5xx; kiểm tra Host status trong Crawl Stats.
- Cấu trúc liên kết nội bộ rõ ràng. Mọi trang quan trọng nên đạt được trong vài lần nhấp từ trang chủ; dùng liên kết HTML thật thay vì chỉ dựa vào JavaScript.
- Khai báo sitemap XML sạch. Chỉ đưa URL chính tắc, trả mã 200 và đáng lập chỉ mục.
- Chuẩn hóa URL. Dùng canonical, tránh tham số thừa và nội dung trùng.
- Tối ưu tài nguyên. Nén hình, giảm CSS/JS thừa để phiên bản render nhẹ.
- Dọn trang lỗi. Xử lý chuỗi chuyển hướng và 404 hàng loạt.
- Theo dõi định kỳ. Xem Crawl Stats hàng tháng và sau mỗi lần thay đổi lớn về cấu trúc.
Về chuyện “ép” Google thu thập nhanh: bạn có thể gửi yêu cầu lập chỉ mục từng URL trong Search Console, nhưng không có cách nào đảm bảo thời gian cụ thể. Google cũng nêu rõ bạn không thể yêu cầu tăng tốc độ thu thập; chỉ có thể xử lý nguyên nhân khiến bot thu thập ít.
Lỗi thường gặp
| Lỗi | Hậu quả | Cách tránh |
|---|---|---|
| Dùng Disallow để “gỡ” trang khỏi Google | Trang vẫn có thể hiện trong kết quả, và noindex không được đọc | Cho phép crawl và dùng noindex, hoặc xóa trang |
| Chặn thư mục chứa CSS/JS | Google render sai, hiểu sai bố cục | Cho phép tài nguyên cần thiết |
| Quên bỏ chặn sau khi chuyển từ bản dev sang bản chính | Toàn site không được thu thập | Checklist ra mắt có bước kiểm tra robots.txt và noindex |
| Chặn IP của Googlebot ở tường lửa vì tưởng là tấn công | Mất lập chỉ mục | Xác minh bot thật, whitelist theo dải IP công bố |
| Trả mã 503 kéo dài khi bảo trì | Suy giảm hiển thị và lập chỉ mục | Bảo trì ngắn, dùng Retry-After; Google khuyến cáo không quá 1 đến 2 ngày |
| Tin hoàn toàn vào user agent trong log | Báo cáo sai về hoạt động bot | Xác minh qua DNS hoặc IP |
Googlebot xử lý JavaScript và render trang ra sao?
Googlebot không chỉ tải HTML thô. Theo tài liệu về JavaScript SEO của Google, trang có JavaScript đi qua ba bước: thu thập, render và lập chỉ mục. Googlebot lấy URL từ hàng đợi, kiểm tra robots.txt, tải HTML; sau đó trang được đưa vào hàng đợi render, nơi một trình duyệt Chromium không giao diện chạy JavaScript; HTML sau render mới được dùng để lập chỉ mục và tìm thêm liên kết. Vì render là bước riêng nên có thể trễ hơn so với việc đọc HTML ban đầu.
| Cách hiển thị nội dung | Googlebot thấy gì | Rủi ro | Khuyến nghị |
|---|---|---|---|
| HTML có sẵn nội dung và liên kết | Thấy ngay khi tải | Thấp | Ưu tiên cho nội dung cốt lõi |
| Render phía máy chủ (SSR) hoặc tạo trang tĩnh | Thấy HTML đầy đủ | Thấp | Phù hợp site nhiều JavaScript |
| Render phía trình duyệt (CSR) | Thấy sau bước render | Trung bình: chậm hoặc lỗi render | Kiểm tra HTML đã render trong URL Inspection |
| Nội dung chỉ hiện sau khi nhấp hoặc cuộn | Thường không thấy nếu không có sự kiện được kích hoạt | Cao | Đưa nội dung quan trọng vào DOM khi tải trang |
| Liên kết dạng nút không có thẻ a với href | Không coi là liên kết để theo dõi | Cao | Dùng thẻ a có href thật |
Cách kiểm tra nhanh: mở URL Inspection, chọn xem trang đã thử nghiệm (Live Test) rồi so HTML đã render với nội dung bạn nhìn thấy trên trình duyệt.
Ví dụ giả định: site thương mại điện tử có 10.000 URL
Ví dụ minh họa giả định, không phải khách hàng thật. Một cửa hàng có 1.000 sản phẩm nhưng bộ lọc màu, giá, sắp xếp sinh ra khoảng 9.000 URL tham số gần giống nhau. Nhật ký máy chủ cho thấy phần lớn lượt truy cập của bot rơi vào URL lọc, trong khi sản phẩm mới mất nhiều ngày mới được thu thập.
| Bước | Việc làm | Mục tiêu |
|---|---|---|
| 1 | Phân tích log, nhóm lượt truy cập bot theo loại URL (sản phẩm, danh mục, tham số) | Biết thời gian bot đang tiêu vào đâu |
| 2 | Chặn crawl các tham số sắp xếp và lọc không cần lập chỉ mục bằng robots.txt | Giảm URL rác |
| 3 | Đặt canonical cho biến thể gần giống về trang gốc | Gộp tín hiệu |
| 4 | Sitemap chỉ chứa URL sản phẩm và danh mục chính tắc, trả 200 | Chỉ đường rõ cho bot |
| 5 | Theo dõi Crawl Stats sau 4 đến 6 tuần | Xem tỷ lệ yêu cầu dành cho URL quan trọng có tăng không |
Kết quả cụ thể tùy từng site và Google không cam kết thời gian. Với site dưới vài nghìn URL, thường chưa cần lo crawl budget. Chi tiết xem crawl budget.
Googlebot khác gì Bingbot và các bot AI?
| Bot | Thuộc về | Mục đích chính | Kiểm soát bằng robots.txt |
|---|---|---|---|
| Googlebot | Lập chỉ mục cho Google Search | Token Googlebot | |
| Bingbot | Microsoft Bing | Lập chỉ mục cho Bing | Token bingbot |
| GPTBot | OpenAI | Thu thập dữ liệu có thể dùng huấn luyện mô hình, theo OpenAI | Token GPTBot |
| Google-Extended | Cho phép hoặc không cho phép dùng nội dung huấn luyện Gemini | Token Google-Extended; không ảnh hưởng lập chỉ mục Search |
Quy tắc này có thể thay đổi, hãy đối chiếu tài liệu của từng nhà cung cấp trước khi chặn. Chặn một bot AI không làm trang biến mất khỏi Google Search nếu bạn không chặn Googlebot.
Câu hỏi thường gặp
Crawl, render và index khác nhau thế nào?
Crawl là tải URL, render là chạy JavaScript để dựng trang hoàn chỉnh, index là lưu thông tin trang vào chỉ mục để có thể hiển thị. Một trang có thể được crawl nhưng chưa render hoặc chưa được index.
Googlebot Smartphone hay Desktop quan trọng hơn?
Với hầu hết site, Google chủ yếu lập chỉ mục bằng phiên bản di động, nên bản mobile cần đủ nội dung, liên kết và dữ liệu có cấu trúc như bản desktop.
Chặn Googlebot bằng robots.txt có làm trang biến mất khỏi Google không?
Không chắc. URL có thể vẫn hiện (chỉ có địa chỉ) nếu có liên kết trỏ tới. Muốn trang không xuất hiện, hãy cho phép crawl và dùng noindex, hoặc bảo vệ bằng mật khẩu.
Googlebot là gì và khác gì Google?
Google là công cụ tìm kiếm và hệ sinh thái sản phẩm, còn Googlebot là phần mềm thu thập dữ liệu của Google Search. Googlebot chỉ đọc và tải trang, việc xếp hạng do các hệ thống khác của Google đảm nhiệm sau đó.
Googlebot có thấy JavaScript không?
Googlebot có thể xử lý JavaScript để hiển thị trang, nhưng việc render tốn tài nguyên và có thể xảy ra lỗi hoặc trễ. Để chắc chắn, hãy đưa nội dung và liên kết quan trọng vào HTML và dùng URL Inspection để xem Google thấy gì.
Bao lâu Googlebot ghé thăm website một lần?
Không có con số cố định. Tần suất phụ thuộc vào tầm quan trọng, mức độ cập nhật và sức khỏe máy chủ của từng trang. Bạn có thể xem xu hướng thực tế trong báo cáo Crawl Stats.
Làm sao để Googlebot thu thập bài mới nhanh hơn?
Đưa URL vào sitemap, gắn liên kết nội bộ từ trang đã được thu thập thường xuyên, đảm bảo trang tải nhanh và không bị chặn, rồi có thể gửi yêu cầu lập chỉ mục trong Search Console. Không có cách nào đảm bảo thời điểm cụ thể.
Có nên chặn Googlebot không?
Chỉ chặn các khu vực không cần xuất hiện hoặc không cần thu thập (trang quản trị, tham số lọc vô hạn). Chặn nhầm toàn site hay tài nguyên cần thiết sẽ làm hỏng khả năng hiển thị. Muốn gỡ trang khỏi kết quả, nên dùng noindex thay vì chỉ dùng robots.txt.
Làm sao biết một request có phải Googlebot thật?
Dùng reverse DNS rồi forward DNS để xác nhận tên miền thuộc googlebot.com, google.com hoặc googleusercontent.com, hoặc so khớp IP với các tệp JSON dải IP Google công bố. User agent một mình không đủ tin cậy.
Googlebot khác Google-Extended thế nào?
Googlebot dùng để lập chỉ mục cho Google Search. Google-Extended là token để bạn kiểm soát việc nội dung có được dùng huấn luyện các thế hệ mô hình Gemini tương lai hay không, theo tài liệu crawler của Google. Hãy đọc kỹ trang chính thức vì phạm vi có thể được cập nhật.
Googlebot có làm chậm website của tôi không?
Googlebot được thiết kế để điều chỉnh theo khả năng máy chủ và thường không truy cập quá một lần mỗi vài giây trung bình. Nếu thấy quá tải thật sự, kiểm tra log để loại trừ bot giả, rồi xử lý hạ tầng; trong tình huống khẩn cấp có thể tạm trả 503 hoặc 429, hoặc gửi yêu cầu qua Search Console, nhưng không nên kéo dài.
Kết luận và bước tiếp theo
Googlebot là cửa ngõ để nội dung của bạn đi vào Google. Việc cần làm: giữ máy chủ ổn định, cấu trúc liên kết rõ ràng, sitemap sạch, dùng đúng robots.txt và noindex, và kiểm tra thường xuyên bằng Crawl Stats cùng URL Inspection. Nếu bài mới vẫn chậm lên chỉ mục, hãy chạy bảng chẩn đoán ở trên từ trên xuống dưới.
Vidco Group có thể hỗ trợ: nếu website của bạn gặp vấn đề thu thập, lập chỉ mục hoặc cần rà soát kỹ thuật toàn diện, bạn có thể tham khảo dịch vụ SEO audit và dịch vụ SEO của chúng tôi để được tư vấn theo hiện trạng thực tế.
Nguồn tham khảo
- Google Search Central: Googlebot
- Google Crawling Infrastructure: Google’s common crawlers
- Google Search Central: Verifying Googlebot and other Google crawlers
- Google Search Central: Reduce the Googlebot crawl rate
- Google Search Console Help: Crawl Stats report
Cập nhật: tháng 10/2026